



































Tu as trouvé cet article utile ?
Fais-le circuler !
Voici le deuxième volet de la série de Percy Grunwald sur Elixir. Ne rate pas le premier article, consacré à la correspondance Unicode en Elixir.
Les exercices d'Exercism sont courts, artificiels et souvent d'apparence anodine. On imagine facilement que des développeurs expérimentés n'auraient rien à y apprendre. Pourtant, résoudre ces problèmes artificiels peut t'amener à découvrir et à appliquer des pans entiers de ton langage que tu n'avais peut-être jamais explorés. Ces nouvelles connaissances peuvent t'aider à résoudre des problèmes concrets de manière plus efficace ou plus expressive.
Fréquence des lettres en parallèle est un exercice de difficulté moyenne du parcours Elixir d'Exercism, qui renferme un nombre surprenant de leçons intéressantes. Pour le résoudre, ta solution doit s'exécuter en parallèle dans plusieurs processus de travail. Atteindre un vrai parallélisme en Elixir est étonnamment simple par rapport à d'autres langages, mais si tu n'as jamais écrit de code concurrent en Elixir, ça peut sembler un peu intimidant. En résolvant cet exercice, tu découvriras entre autres à quel point Elixir facilite l'écriture de code capable de s'exécuter de manière concurrente ou parallèle. Appliquer ces compétences à ton code peut avoir un impact considérable sur les performances de tes applications.
Cet exercice te demande d'implémenter une fonction, Frequency.frequency/2, qui détermine la fréquence des lettres dans une liste de strings. Le calcul doit être effectué dans plusieurs processus de travail, dont le nombre est fixé par l'argument workers :
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
Dans cet article, on va explorer la concurrence en Elixir en rendant concurrente une solution séquentielle qui fonctionne. Mais avant de plonger dans le code, prenons un instant pour examiner ce que signifient vraiment « concurrence » et « parallélisme », et comment obtenir l'un comme l'autre en Elixir par rapport à d'autres langages.
Concurrence et parallélisme
La concurrence et le parallélisme sont deux notions proches, mais elles ne désignent pas exactement la même chose. Un programme concurrent est un programme dans lequel plusieurs tâches peuvent être « en cours », mais à un instant donné, une seule tâche s'exécute sur le processeur (par exemple, exécuter une tâche pendant qu'une autre attend des entrées-sorties, comme une lecture ou une écriture sur le disque ou sur le réseau). À l'inverse, un programme parallèle est capable d'exécuter plusieurs tâches en même temps sur plusieurs cœurs de processeur.
L'exécution concurrente comme l'exécution parallèle peuvent apporter des gains de vitesse considérables, mais l'ampleur du gain possible, quand il y en a un, dépend de nombreux facteurs. Dans certains cas, la concurrence ou le parallélisme ne sont même pas envisageables : il se peut que la tâche que tu cherches à accomplir ne se prête ni à une exécution concurrente ni à une exécution parallèle, ou que l'environnement d'exécution ne les prenne pas en charge. Si ton cas se prête à une exécution concurrente ou parallèle, l'ampleur du gain dépend en grande partie du fait que la tâche est limitée par les entrées-sorties ou par le processeur, et de la disponibilité de plus d'un cœur de processeur.
Malgré le nombre de facteurs en jeu, il existe quelques « règles empiriques » pour déterminer si la concurrence ou le parallélisme sont possibles et quel gain de vitesse espérer. Premièrement, l'exécution concurrente est possible sur un seul cœur de processeur, mais pas l'exécution parallèle. Deuxièmement, le parallélisme et la concurrence devraient apporter un gain de vitesse considérable aux tâches limitées par les entrées-sorties, et ce gain devrait être à peu près identique dans les deux cas. Enfin, les tâches limitées par le processeur devraient avoir les mêmes performances (ou des performances moindres) lorsqu'elles sont exécutées de manière concurrente, et les gains de vitesse ne sont en général possibles que lorsqu'elles sont exécutées en parallèle sur plusieurs cœurs de processeur.
Le calcul de fréquence des lettres dans cet exercice est un exemple de tâche limitée par le processeur ; d'après les règles empiriques ci-dessus, un gain de vitesse ne devrait donc être possible qu'en effectuant le calcul en parallèle sur plusieurs cœurs de processeur.
Concurrence et parallélisme en Elixir par rapport à d'autres langages
Beaucoup de langages populaires te fournissent des outils pour écrire du code concurrent, mais atteindre le parallélisme est généralement bien plus complexe et semé de compromis.
Par exemple, la concurrence est un citoyen de première classe en JavaScript exécuté sur l'environnement d'exécution Node.js, et les versions par défaut des fonctions liées aux entrées-sorties sont presque toujours « asynchrones » (c'est-à-dire concurrentes). Par exemple, fs.ReadFile est une fonction concurrente et la façon standard de lire le contenu d'un fichier. C'est très pratique, mais ça a aussi ses inconvénients, sous la forme de l'enfer des callbacks ou de la nécessité de recourir aux Promises. De plus, comme Node ne répartit pas le temps processeur équitablement entre les tâches, une seule tâche gourmande en processeur peut toujours bloquer l'exécution. Paralléliser l'exécution sous Node est possible, mais certainement pas facile. Étant donné que Node est monothread, la seule façon d'atteindre le parallélisme est de créer manuellement des processus de travail avec le module cluster, ou d'exécuter plusieurs instances de ton programme et d'implémenter toi-même la communication entre elles.
Python, contrairement à Node, n'est pas concurrent par défaut, mais il t'offre plusieurs outils pour écrire du code concurrent et parallèle. Cependant, chaque option a ses compromis et le choix n'est pas forcément évident. Tu pourrais utiliser le module threading et composer avec le fait que le global interpreter lock (GIL) limite l'exécution à un seul thread à la fois, ce qui rend le parallélisme impossible. L'autre option est le module multiprocessing de Python, qui contourne la limitation du GIL en créant des processus du système d'exploitation (et non des threads). Utiliser multiprocessing rend le parallélisme possible, mais avec le compromis que les processus du système d'exploitation sont plus lents à créer et consomment plus de mémoire que les threads.
Écrire du code concurrent et parallèle en Elixir est beaucoup plus simple, car Elixir est concurrent au niveau de l'environnement d'exécution. La réputation d'Elixir en matière de scalabilité massive vient du fait qu'il tourne sur la machine virtuelle BEAM, qui exécute tout le code à l'intérieur de « processus » extrêmement légers, lesquels s'exécutent tous de manière concurrente au sein de la VM. Les processus BEAM ont un coût de création négligeable et consomment une quantité infime de mémoire par rapport aux threads et processus du système d'exploitation créés par les modules de concurrence de Python. De plus, contrairement à la boucle d'événements de Node, la VM BEAM dispose d'ordonnanceurs qui allouent le temps processeur disponible à tous les processus, ce qui garantit qu'une seule tâche gourmande en processeur ne peut pas empêcher les autres processus de s'exécuter.
Grâce à cette architecture, passer de l'exécution concurrente des processus à leur exécution en parallèle revient simplement à ajouter des cœurs de processeur. En fait, depuis plusieurs années déjà, BEAM active automatiquement les capacités de multiprocessing symétrique (SMP) sur les systèmes multicœurs, ce qui permet aux ordonnanceurs de la VM d'allouer aux processus en cours le temps processeur de tous les cœurs. En Elixir, non seulement la concurrence est un citoyen de première classe, mais il n'y a aucune distinction entre le code concurrent et le code parallèle. Tout ce que tu as à faire, c'est écrire du code concurrent : la VM le parallélisera automatiquement et par défaut s'il y a plus d'un cœur de processeur disponible.
Écrire du code Elixir concurrent avec le module Task
Comme mentionné plus haut, en Elixir, la concurrence s'obtient en répartissant les opérations sur plusieurs processus BEAM. Tu peux très facilement créer des processus avec des fonctions comme Kernel.spawn_link/1, mais tu as tout intérêt à utiliser les abstractions redoutablement puissantes fournies par le module Task :
Le cas d'usage le plus courant de [Task] est de transformer du code séquentiel en code concurrent en calculant une valeur de manière asynchrone.
Le module Task te permet d'écrire du code concurrent incroyablement propre en Elixir, sans enfer des callbacks ni besoin de Promises.
Pour cet exercice, Task.async_stream/3 est une excellente option :
async_stream(enumerable, function, options \\ [])
Task.async_stream/3 renvoie un flux qui exécute la function donnée de manière concurrente sur chaque élément d'enumerable. Par défaut, le nombre de processus créés (les processus de travail) est égal au nombre d'éléments d'enumerable. Cela nous donne un moyen simple de contrôler le niveau de parallélisme grâce à l'argument workers (à condition d'avoir assez de cœurs de processeur). Il nous suffit de découper la liste de lettres en un nombre de morceaux approprié et d'utiliser Task.async_stream/3 pour traiter chaque morceau dans un processus de travail distinct.
Rendre concurrente la fonction séquentielle de fréquence des lettres
Commençons par une implémentation séquentielle fonctionnelle, tirée de ma solution :
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
On peut rendre l'implémentation ci-dessus concurrente en procédant comme suit :
- Découper la liste de graphèmes renvoyée par
get_all_graphemes/1en un nombre de morceaux égal au nombre deworkers - Traiter chaque morceau avec
count_letters/1dans un processus de travail, à l'aide deTask.async_stream/3 - Fusionner les résultats de chaque processus de travail en un seul résultat
Voici un schéma des étapes ci-dessus :
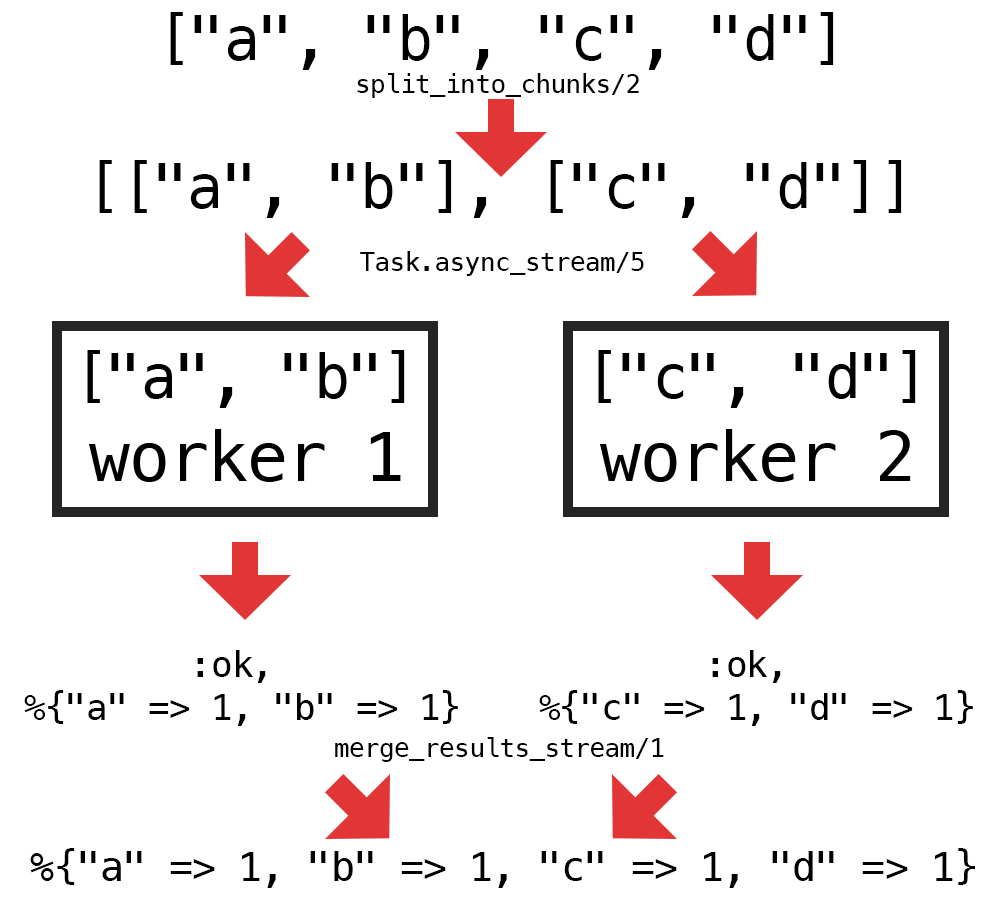
Il nous suffit d'implémenter 2 nouvelles fonctions auxiliaires pour mettre en place la logique concurrente : une pour découper les graphèmes en morceaux (split_into_chunks/2) et une pour fusionner le stream de résultats provenant des processus de travail (merge_results/1). Voici une façon d'implémenter ces fonctions auxiliaires :
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
Une fois ces 2 fonctions implémentées, il ne reste plus qu'à ajouter les appels aux nouvelles fonctions auxiliaires et à remplacer l'appel direct à count_letters/1 par Task.async_stream/3 pour que la fonction frequency/2 s'exécute de manière concurrente :
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
La fonction ci-dessus est une implémentation concurrente pleinement fonctionnelle, et elle passe tous les tests. Bien qu'elle soit concurrente, le code se lit exactement comme du code séquentiel classique, ce qui démontre la puissance des abstractions fournies par Task.
La version concurrente est-elle vraiment parallèle ?
Comme je l'ai mentionné plus haut dans cet article, il n'y a aucune distinction entre le code concurrent et le code parallèle en Elixir. Si on donne à workers une valeur supérieure à 1, et qu'on dispose de plus d'un cœur de processeur, la VM BEAM parallélise automatiquement l'exécution des processus créés.
Par défaut, BEAM démarre un ordonnanceur pour chaque cœur de processeur (logique) disponible. Tu peux vérifier le nombre d'ordonnanceurs démarrés par BEAM avec :erlang.system_info/1 :
iex> :erlang.system_info(:schedulers_online)
8
Cela représente le nombre maximal de processus de la VM pouvant s'exécuter en même temps. Donner à workers une valeur supérieure au nombre d'ordonnanceurs n'augmente pas le parallélisme et peut nuire aux performances.
Conclusion
Convertir le code du séquentiel au concurrent s'avère bien plus simple que prévu grâce au module Task d'Elixir. Le code concurrent ajoute un peu de complexité, dans le découpage de la liste de graphèmes et la combinaison des résultats des processus de travail, mais le résultat final est étonnamment propre.
Avant de résoudre ce problème Exercism, j'avais entendu parler de Task, mais je ne l'avais jamais utilisé. Après l'avoir appliqué dans ma solution, je le considère désormais comme un élément indispensable de ma boîte à outils Elixir.
Tu pourrais utiliser ce nouvel outil de bien des façons pour tenter d'optimiser les performances de tes applications. La plupart des applications web sont limitées par les entrées-sorties et profiteraient donc de la concurrence, même s'il n'y a qu'un seul cœur de processeur disponible. Un moyen assez fiable d'accélérer une application web consiste à lancer les requêtes HTTP de manière concurrente :
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
Le code ci-dessus applique Task.async_stream/3 pour appeler toutes les URL de la liste de manière concurrente, au lieu d'attendre la fin de chaque requête avant de lancer la suivante, ce qui devrait apporter un gain de vitesse considérable selon la durée de chaque requête.

