



































觉得这篇文章有用吗?
分享出去吧!
这是 Percy Grunwald 的 Elixir 系列文章的第二篇。别忘了阅读第一篇关于 Elixir 中的 Unicode 匹配的文章。
Exercism 上的练习都很小,是人为构造出来的,而且往往看上去微不足道。大家很容易以为,经验丰富的开发者从这些练习里学不到任何东西。然而,解决这些人为设计的问题,会促使你去学习和运用这门语言中你也许从未涉足的部分。这些新学到的东西,能帮助你更高效、更富表现力地解决现实中的问题。
并行字母频率 是 Exercism 的 Elixir 学习路径上的一道中等难度练习,其中蕴含着数量多得惊人的有趣知识。要成功解决这道题,你的解答需要在多个工作进程中并行执行。与其他语言相比,在 Elixir 中实现真正的并行出奇地容易;但如果你从未用 Elixir 写过并发代码,它可能会让你有点望而生畏。在解决这道练习的过程中,你会发现:Elixir 让编写可并发或并行执行的代码变得多么容易。把这些技能用到自己的代码里,能显著影响应用程序的性能。
这道练习要求你实现一个函数Frequency.frequency/2,它用于统计一组字符串中各个字母的出现频率。计算应在多个工作进程中完成,进程数量由workers参数决定:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
在这篇文章中,我们会把这道练习中一个可以正常运行的顺序解答改成并发版本,以此来探索 Elixir 中的并发。不过,在开始看代码之前,我们先花点时间弄清楚“并发”和“并行”到底是什么意思,以及在 Elixir 和其他语言中分别如何实现这两者。
并发与并行
并发和并行是两个相关的术语,但含义并不完全相同。所谓_并发_程序,是指多个任务可以同时“进行中”,但在任意一个时间点上,CPU 上只有一个任务在执行(例如,执行一个任务的同时,另一个任务正在等待 IO,比如读写磁盘或网络)。另一方面,_并行_程序能够在多个 CPU 核心上_同时_执行多个任务。
并发执行和并行执行都能带来明显的速度提升,但能提升多少(如果有的话)取决于许多因素。有些情况下,并发或并行根本不可能实现:你要完成的任务也许既不适合并发执行,也不适合并行执行,或者运行时本身不支持它们。如果你的场景_确实_允许并发或并行执行,那么能获得的加速幅度在很大程度上取决于任务是 IO 密集型还是 CPU 密集型,以及可用的 CPU 核心是否超过 1 个。
尽管影响因素众多,判断能否使用并发或并行、以及能期待多少加速,还是有一些“经验法则”可以参考。首先,并发执行在单个 CPU 核心上就可以实现,而并行执行不行。其次,对于 IO 密集型任务,并行和并发都应该带来明显的加速,而且两者的加速幅度大致相同。最后,CPU 密集型任务在并发执行时性能应该持平(甚至更慢),通常只有跨多个 CPU 核心并行执行时才可能提速。
这道练习中的字母频率统计就是一个 CPU 密集型任务的例子,所以按照上面的经验法则,只有把计算放到多个 CPU 核心上并行进行,才可能提速。
Elixir 与其他语言中的并发与并行
许多流行语言都提供了编写并发代码的工具,但要实现并行通常复杂得多,而且充满取舍。
例如,在 Node.js 运行时上运行的 JavaScript 中,并发是一等公民,与 IO 相关的函数默认版本几乎总是“异步”的(也就是并发的)。例如,fs.ReadFile就是一个并发函数,也是读取文件内容的标准方式。这很不错,但也有缺点,比如回调地狱,或者不得不使用 Promises。此外,由于 Node 不会在各个任务之间平均分配 CPU 时间,一个 CPU 密集型任务仍然有可能阻塞整个执行。在 Node 中实现并行执行是可能的,但绝对不容易。考虑到 Node 是单线程的,实现并行的唯一办法就是用cluster模块手动 fork 出工作进程,或者运行程序的多个实例,并手动实现它们之间的通信。
与 Node 不同,Python 默认并不是并发的,但它确实提供了多种编写并发和并行代码的工具。不过,每个选项都有取舍,做选择也并不总是那么简单。你可以使用threading模块,但要接受一个事实:global interpreter lock (GIL)会把执行限制为同一时间只有一个线程,因此无法实现并行。另一种选择是 Python 的 multiprocessing 模块,它通过创建操作系统进程(而不是线程)来绕过 GIL 的限制。使用multiprocessing可以实现并行,但代价是操作系统进程的创建比线程更慢,占用的内存也更多。
在 Elixir 中编写并发和并行代码要简单得多,因为 Elixir 在运行时层面就是并发的。Elixir 以大规模可扩展性著称,原因在于它运行在 BEAM 虚拟机上,所有代码都在极其轻量的“进程”中执行,而这些进程都在虚拟机内并发运行。与 Python 的并发模块创建的操作系统级线程和进程相比,BEAM 进程的创建成本几乎可以忽略不计,占用的内存也极少。此外,与 Node 的事件循环不同,BEAM 虚拟机拥有调度器,可以把可用的 CPU 时间分配给所有进程,从而确保单个 CPU 密集型任务不会阻塞其他进程的执行。
正因为有这种架构,从并发执行进程转为并行执行,只需增加更多 CPU 核心。事实上,多年来 BEAM 都会在多核系统上自动启用对称多处理(SMP)能力,让虚拟机的调度器可以把所有核心的 CPU 时间分配给正在运行的进程。在 Elixir 中,并发不仅是一等公民,而且并发代码与并行代码之间没有任何区别。你需要做的只是编写并发代码,只要可用的 CPU 核心多于 1 个,虚拟机就会_自动_、_默认_地把它并行化。
使用Task模块编写 Elixir 并发代码
如前所述,在 Elixir 中,并发是通过把操作分配到多个 BEAM 进程来实现的。你可以用 Kernel.spawn_link/1 之类的函数轻松创建进程,但更好的做法是使用 Task 模块提供的强大抽象:
[Task] 最常见的用例是:通过异步计算一个值,把顺序代码转换成并发代码。
Task模块让你能在 Elixir 中写出_难以置信地简洁_的并发代码,没有回调地狱,也用不着Promises。
对于这道练习,Task.async_stream/3是个很好的选择:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3会返回一个流,它针对enumerable中的每一项并发运行给定的function。默认情况下,创建的进程数(也就是工作进程数)等于enumerable中的元素个数。这让我们可以用workers参数直接控制并行度(前提是 CPU 核心足够)。我们只需要把字母列表拆分成正确数量的块,然后用Task.async_stream/3在各自的工作进程中处理每一块。
让顺序的字母频率函数并发运行
我们先从一个可以正常运行的顺序实现开始,它来自我的解答:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
只要按下面的步骤做,就能把上面的实现改成并发版本:
- 把
get_all_graphemes/1返回的字素列表拆分成若干块,块数等于workers的数量 - 使用
Task.async_stream/3,在工作进程中用count_letters/1处理每个块 - 把各个工作进程的结果合并成一个结果
下面是上述步骤的示意图:
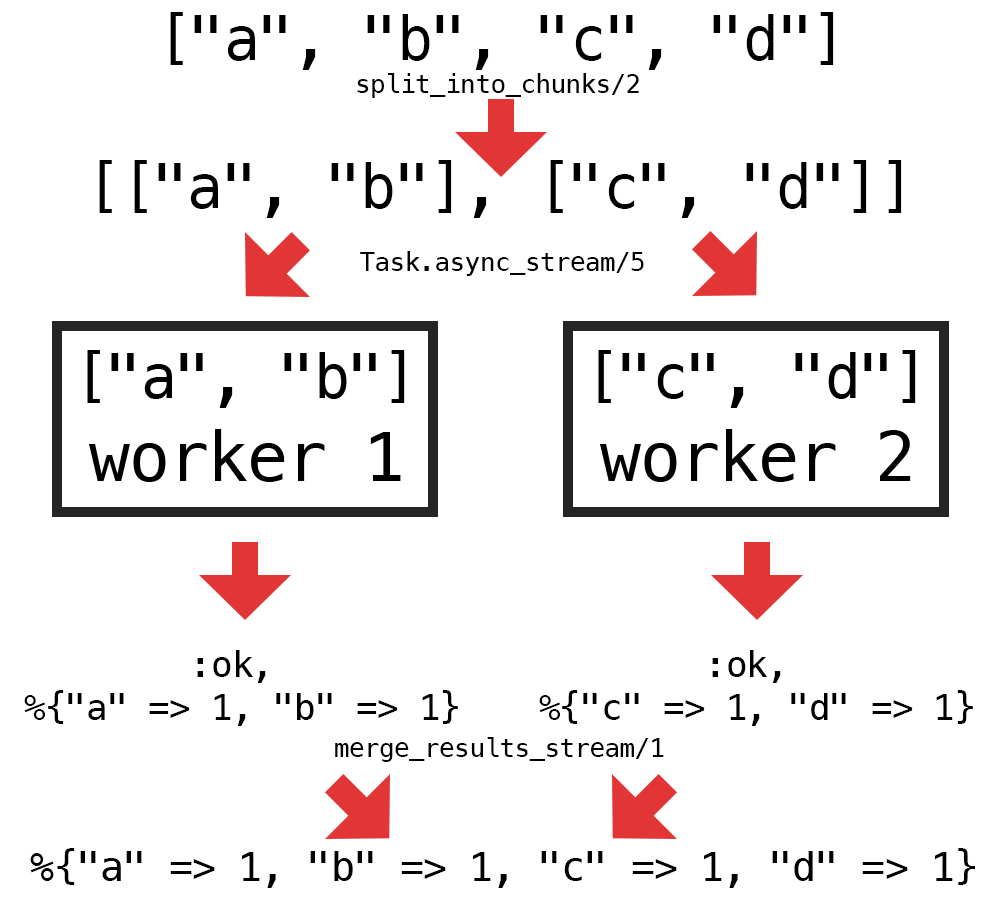
要启用并发逻辑,我们只需实现 2 个新的辅助函数:一个把字素拆分成块(split_into_chunks/2),另一个把各工作进程返回的结果stream合并起来(merge_results/1)。下面是实现这两个辅助函数的一种方式:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
实现这 2 个函数之后,要让frequency/2并发运行,剩下的就是加上对新辅助函数的调用,并把对count_letters/1的直接调用换成Task.async_stream/3:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
上面的函数是一个可以完整运行的并发实现,能通过所有测试。尽管是并发的,这段代码读起来和普通的顺序代码一模一样,这正体现了Task所提供的抽象的威力。
并发版本真的并行了吗?
正如我在前面提到的,在 Elixir 中,并发代码和并行代码之间没有区别。如果我们把workers设为大于 1 的数,并且可用的 CPU 核心多于 1 个,BEAM 虚拟机就会自动把所创建进程的执行并行化。
默认情况下,BEAM 会为每个可用的逻辑 CPU 核心启动一个调度器。你可以用:erlang.system_info/1查看 BEAM 启动的调度器数量:
iex> :erlang.system_info(:schedulers_online)
8
这表示同一时间可以执行的虚拟机进程的最大数量。把workers设成_大于_调度器数量的值时,并不会提高并行度,反而可能损害性能。
结语
借助 Elixir 的Task模块,把代码从顺序改成并发,结果比想象中容易得多。并发代码在拆分字素列表和合并工作进程结果方面多了一点复杂度,但最终的结果出奇地简洁。
在解决这道 Exercism 题目之前,我听说过Task,但从未用过。在把它用到我的解答中之后,我现在会把它看作自己 Elixir 工具箱里不可或缺的一部分。
你可以用这个新工具做很多事情,来尝试优化应用程序的性能。大多数 Web 应用都是 IO 密集型的,因此即使只有一个 CPU 核心可用,也能从并发中获益。一种相当可靠的 Web 应用提速方式,就是并发地发起 HTTP 请求:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
上面的代码用 Task.async_stream/3 并发调用列表中的所有 URL,而不是等一个请求完成后再发起下一个。这样应该能带来明显的加速,具体幅度取决于每个请求的耗时。

