



































Fandest du diesen Beitrag hilfreich?
Teile ihn weiter!
Dies ist der zweite Teil von Percy Grunwalds Serie über Elixir. Verpasse nicht den ersten Artikel über Unicode-Matching in Elixir.
Die Übungen auf Exercism sind klein, synthetisch und wirken oft trivial. Man könnte leicht annehmen, dass erfahrene Entwickler daraus nichts lernen könnten. Doch wenn du diese synthetischen Probleme löst, kann dich das dazu bringen, Teile deiner Sprache zu lernen und anzuwenden, die du vielleicht noch nie erkundet hast. Dieses neue Wissen kann dir helfen, Probleme aus der Praxis effizienter oder ausdrucksstärker zu lösen.
Parallele Buchstabenhäufigkeit ist eine Übung mittlerer Schwierigkeit im Elixir-Track von Exercism, die eine überraschend große Zahl interessanter Lektionen bereithält. Um dieses Problem erfolgreich zu lösen, sollte deine Lösung parallel in mehreren Worker-Prozessen ausgeführt werden. Echte Parallelität in Elixir zu erreichen ist überraschend einfach im Vergleich zu anderen Sprachen, aber wenn du noch nie nebenläufigen Code in Elixir geschrieben hast, kann das ein wenig entmutigend wirken. Eine der Dinge, die du beim Lösen dieser Übung entdeckst, ist, wie einfach Elixir es macht, Code zu schreiben, der nebenläufig oder parallel ausgeführt werden kann. Wenn du diese Fähigkeiten auf deinen Code anwendest, kann das einen erheblichen Einfluss auf die Leistung deiner Anwendungen haben.
In dieser Übung sollst du eine Funktion Frequency.frequency/2 implementieren, die die Buchstabenhäufigkeit in einer Liste von Strings ermittelt. Die Berechnung soll in mehreren Worker-Prozessen erfolgen, deren Anzahl durch das Argument workers festgelegt wird:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
In diesem Artikel erkunden wir Nebenläufigkeit in Elixir, indem wir eine funktionierende sequenzielle Lösung dieser Übung nebenläufig machen. Doch bevor wir in den Code eintauchen, schauen wir uns kurz an, was „Nebenläufigkeit“ und „Parallelität“ eigentlich bedeuten und wie man beides in Elixir im Vergleich zu anderen Sprachen erreicht.
Nebenläufigkeit und Parallelität
Nebenläufigkeit und Parallelität sind verwandte Begriffe, bedeuten aber nicht genau dasselbe. Ein nebenläufiges Programm ist eines, in dem mehrere Aufgaben „in Bearbeitung“ sein können, aber zu jedem einzelnen Zeitpunkt führt die CPU nur eine Aufgabe aus (zum Beispiel führt sie eine Aufgabe aus, während eine andere auf IO wartet, etwa auf das Lesen oder Schreiben auf die Festplatte oder über das Netzwerk). Ein paralleles Programm hingegen kann mehrere Aufgaben gleichzeitig auf mehreren CPU-Kernen ausführen.
Sowohl nebenläufige als auch parallele Ausführung kann zu erheblichen Geschwindigkeitsgewinnen führen, aber wie viel Beschleunigung möglich ist (falls überhaupt), hängt von vielen Faktoren ab. Es gibt Fälle, in denen Nebenläufigkeit oder Parallelität gar nicht möglich ist. Vielleicht eignet sich die Aufgabe, die du lösen möchtest, weder für nebenläufige noch für parallele Ausführung, oder die Laufzeitumgebung unterstützt sie nicht. Wenn dein Fall nebenläufige oder parallele Ausführung tatsächlich erlaubt, hängt die mögliche Beschleunigung größtenteils davon ab, ob die Aufgabe IO- oder CPU-gebunden ist und ob mehr als 1 CPU-Kern verfügbar ist.
Trotz der vielen Einflussfaktoren gibt es ein paar „Faustregeln“, mit denen sich bestimmen lässt, ob Nebenläufigkeit oder Parallelität möglich ist und wie viel Beschleunigung zu erwarten ist. Erstens ist nebenläufige Ausführung auf einem einzigen CPU-Kern möglich, parallele Ausführung dagegen nicht. Zweitens sollten Parallelität und Nebenläufigkeit IO-gebundenen Aufgaben eine erhebliche Beschleunigung bringen, und die Beschleunigung sollte bei beiden nominell gleich sein. Und schließlich sollten CPU-gebundene Aufgaben bei nebenläufiger Ausführung dieselbe (oder eine schlechtere) Leistung haben, und generell sind Geschwindigkeitsgewinne nur bei paralleler Ausführung über mehrere CPU-Kerne möglich.
Die Berechnung der Buchstabenhäufigkeit in dieser Übung ist ein Beispiel für eine CPU-gebundene Aufgabe. Nach den Faustregeln oben ist ein Geschwindigkeitsgewinn also nur möglich, wenn du die Berechnung parallel auf mehreren CPU-Kernen durchführst.
Nebenläufigkeit und Parallelität in Elixir im Vergleich zu anderen Sprachen
Viele populäre Sprachen geben dir Werkzeuge, um nebenläufigen Code zu schreiben, aber echte Parallelität zu erreichen ist meist viel komplexer und voller Kompromisse.
Zum Beispiel ist Nebenläufigkeit in JavaScript, das auf der Node.js-Laufzeitumgebung läuft, ein Bürger erster Klasse, und die Standardvarianten IO-bezogener Funktionen sind fast immer „asynchron“ (das heißt nebenläufig). Zum Beispiel ist fs.ReadFile eine nebenläufige Funktion und der Standardweg, um den Inhalt einer Datei zu lesen. Das ist großartig, hat aber auch seine Schattenseiten in Form von Callback-Hölle oder der Notwendigkeit von Promises. Außerdem, da Node die CPU-Zeit nicht gleichmäßig auf die Aufgaben verteilt, kann eine einzige CPU-intensive Aufgabe die Ausführung weiterhin blockieren. Die Ausführung in Node zu parallelisieren ist möglich, aber sicher nicht einfach. Da Node single-threaded ist, besteht die einzige Möglichkeit, Parallelität zu erreichen, darin, mit dem cluster-Modul manuell Worker-Prozesse zu forken oder mehrere Instanzen deines Programms auszuführen und die Kommunikation zwischen ihnen selbst zu implementieren.
Python ist, anders als Node, nicht von Haus aus nebenläufig, bietet dir aber mehrere Werkzeuge, um nebenläufigen und parallelen Code zu schreiben. Jede Option hat jedoch ihre Kompromisse, und die Wahl einer davon ist nicht unbedingt einfach. Du könntest das threading-Modul verwenden und dich damit abfinden, dass der global interpreter lock (GIL) die Ausführung auf einen einzigen Thread gleichzeitig beschränkt, was Parallelität unmöglich macht. Die andere Option ist Pythons multiprocessing-Modul, das die GIL-Einschränkung umgeht, indem es Betriebssystem-Prozesse erzeugt (im Gegensatz zu Threads). Die Verwendung von multiprocessing macht Parallelität möglich, hat aber den Nachteil, dass Prozesse des Betriebssystems langsamer erzeugt werden und mehr Speicher belegen als Threads.
Nebenläufigen und parallelen Code in Elixir zu schreiben ist viel einfacher, da Elixir auf Ebene der Laufzeitumgebung nebenläufig ist. Elixirs Ruf als extrem skalierbare Sprache kommt daher, dass es auf der virtuellen Maschine BEAM läuft, die den gesamten Code in extrem leichtgewichtigen „Prozessen“ ausführt, die alle innerhalb der VM nebenläufig laufen. BEAM-Prozesse kosten beim Erzeugen vernachlässigbar wenig und verbrauchen winzige Mengen Speicher im Vergleich zu den Threads und Prozessen auf Betriebssystemebene, die Pythons Nebenläufigkeitsmodule erzeugen. Außerdem hat die BEAM-VM im Gegensatz zu Nodes Event-Loop Scheduler, die die verfügbare CPU-Zeit auf alle Prozesse verteilen. So wird sichergestellt, dass eine einzelne CPU-intensive Aufgabe andere Prozesse nicht an der Ausführung hindern kann.
Dank dieser Architektur ist der Wechsel von nebenläufiger zu paralleler Ausführung nur eine Frage zusätzlicher CPU-Kerne. Tatsächlich aktiviert BEAM seit vielen Jahren auf Mehrkernsystemen automatisch die Möglichkeiten von Symmetric Multiprocessing (SMP), wodurch die Scheduler der VM die CPU-Zeit aller Kerne auf die laufenden Prozesse verteilen können. In Elixir ist Nebenläufigkeit nicht nur ein Bürger erster Klasse, es gibt auch keinen Unterschied zwischen nebenläufigem und parallelem Code. Du musst nur nebenläufigen Code schreiben, und die VM parallelisiert ihn automatisch und standardmäßig, wenn mehr als 1 CPU-Kern verfügbar ist.
Nebenläufigen Elixir-Code mit dem Task-Modul schreiben
Wie oben erwähnt, erreicht man Nebenläufigkeit in Elixir, indem man Operationen auf mehrere BEAM-Prozesse verteilt. Du kannst Prozesse ganz einfach mit Funktionen wie Kernel.spawn_link/1 erzeugen, aber du fährst viel besser damit, die großartig mächtigen Abstraktionen des Task-Moduls zu nutzen:
Der häufigste Anwendungsfall für [Task] ist es, sequenziellen Code in nebenläufigen Code umzuwandeln, indem ein Wert asynchron berechnet wird.
Das Task-Modul lässt dich unglaublich sauberen nebenläufigen Code in Elixir schreiben, ganz ohne Callback-Hölle und ohne Bedarf für Promises.
Für diese Übung ist Task.async_stream/3 eine großartige Option:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3 gibt einen Stream zurück, der die angegebene function nebenläufig für jedes Element in enumerable ausführt. Standardmäßig entspricht die Anzahl der erzeugten Prozesse (Worker) der Anzahl der Elemente in enumerable. So haben wir mit dem Argument workers eine unkomplizierte Möglichkeit, den Grad der Parallelität zu steuern (vorausgesetzt, wir haben genug CPU-Kerne). Wir müssen nur die Liste der Buchstaben in die richtige Anzahl von Abschnitten aufteilen und Task.async_stream/3 verwenden, um jeden Abschnitt in einem eigenen Worker zu verarbeiten.
Die sequenzielle Funktion zur Buchstabenhäufigkeit nebenläufig machen
Beginnen wir mit einer funktionierenden sequenziellen Implementierung aus meiner Lösung:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
Wir können die obige Implementierung nebenläufig machen, indem wir Folgendes tun:
- Teile die von
get_all_graphemes/1zurückgegebene Liste von Graphemen in so viele Abschnitte auf, wie esworkersgibt - Verarbeite jeden Abschnitt mit
count_letters/1in einem Worker, indem duTask.async_stream/3verwendest - Führe die Ergebnisse aller Worker zu einem einzigen Ergebnis zusammen
Hier ist ein Diagramm der obigen Schritte:
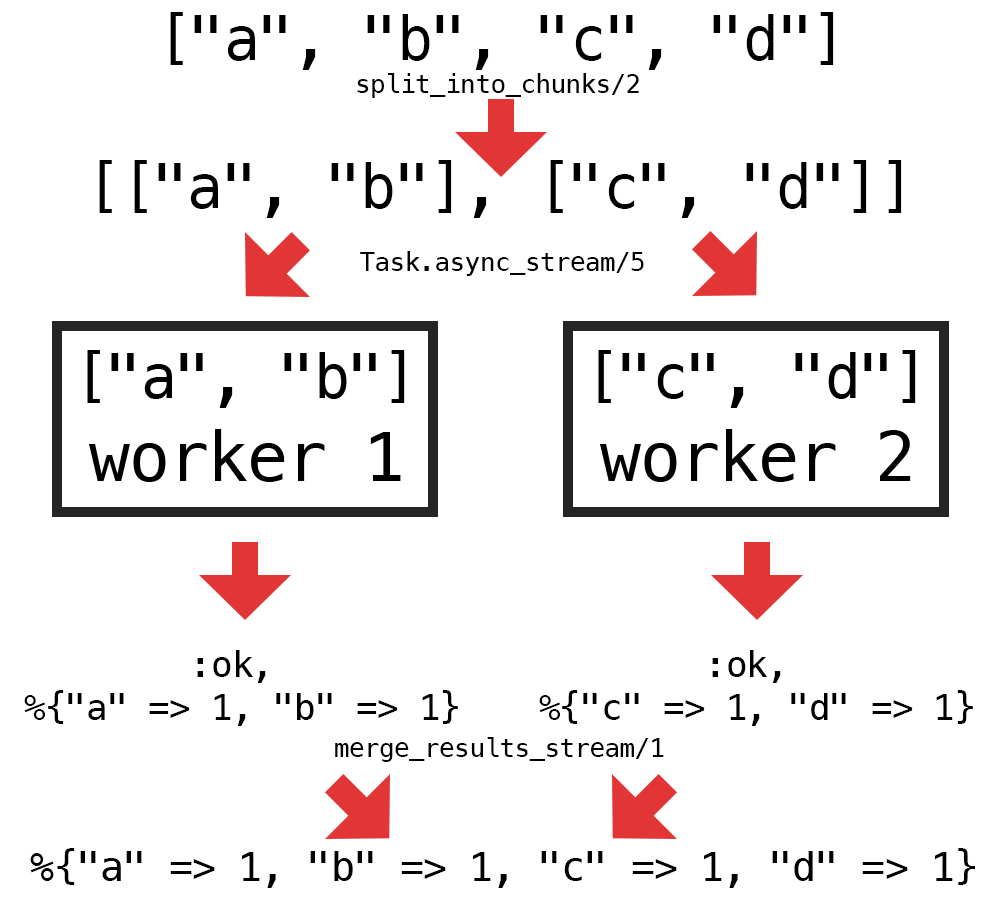
Wir müssen nur 2 neue Hilfsfunktionen implementieren, um die nebenläufige Logik zu ermöglichen: eine, um die Grapheme in Abschnitte aufzuteilen (split_into_chunks/2), und eine, um den stream der Ergebnisse aus den Workern zusammenzuführen (merge_results/1). Hier ist eine Möglichkeit, diese Hilfsfunktionen zu implementieren:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
Nachdem diese 2 Funktionen implementiert sind, musst du, um die Funktion frequency/2 nebenläufig auszuführen, nur noch Aufrufe der neuen Hilfsfunktionen hinzufügen und den direkten Aufruf von count_letters/1 durch Task.async_stream/3 ersetzen:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
Die obige Funktion ist eine voll funktionsfähige nebenläufige Implementierung und besteht alle Tests. Obwohl sie nebenläufig ist, liest sich der Code genau wie gewöhnlicher sequenzieller Code. Das zeigt, wie mächtig die Abstraktionen in Task sind.
Ist die nebenläufige Version wirklich parallel?
Wie ich weiter oben im Artikel erwähnt habe, gibt es in Elixir keinen Unterschied zwischen nebenläufigem und parallelem Code. Wenn wir workers auf eine Zahl größer als 1 setzen und mehr als 1 CPU-Kern verfügbar ist, parallelisiert die BEAM-VM die Ausführung der erzeugten Prozesse automatisch.
Standardmäßig startet BEAM für jeden verfügbaren (logischen) CPU-Kern einen Scheduler. Die Anzahl der von BEAM gestarteten Scheduler kannst du mit :erlang.system_info/1 prüfen:
iex> :erlang.system_info(:schedulers_online)
8
Das ist die maximale Anzahl von VM-Prozessen, die gleichzeitig ausgeführt werden können. Wenn du workers auf eine Zahl größer als die Anzahl der Scheduler setzt, erhöht das die Parallelität nicht und kann die Leistung beeinträchtigen.
Fazit
Den Code von sequenziell auf nebenläufig umzustellen ist mit Elixirs Task-Modul viel einfacher als erwartet. Der nebenläufige Code bringt etwas zusätzliche Komplexität beim Aufteilen der Graphemliste und beim Zusammenführen der Ergebnisse der Worker mit sich, aber das Endergebnis ist überraschend sauber.
Bevor ich dieses Exercism-Problem gelöst habe, hatte ich von Task gehört, es aber nie benutzt. Nachdem ich es in meiner Lösung eingesetzt habe, würde ich es inzwischen als unverzichtbaren Teil meines Elixir-Werkzeugkastens betrachten.
Du könntest dieses neue Werkzeug auf viele Arten einsetzen, um die Leistung deiner Anwendungen zu optimieren. Die meisten Webanwendungen sind IO-gebunden und würden daher von Nebenläufigkeit profitieren, selbst wenn nur ein einziger CPU-Kern verfügbar ist. Eine ziemlich zuverlässige Möglichkeit, eine Webanwendung zu beschleunigen, ist es, HTTP-Anfragen nebenläufig zu stellen:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
Der obige Code verwendet Task.async_stream/3, um alle URLs in der Liste nebenläufig aufzurufen, statt auf den Abschluss jeder Anfrage zu warten, bevor die nächste gestartet wird. Das sollte je nach Dauer der einzelnen Anfrage eine erhebliche Beschleunigung bringen.

