



































Achou este post útil?
Compartilhe!
Este é o segundo artigo da série de Percy Grunwald sobre Elixir. Não perca o primeiro artigo sobre Correspondência de Unicode no Elixir.
Os exercícios do Exercism são pequenos, sintéticos e muitas vezes aparentemente triviais. É fácil imaginar que profissionais experientes não teriam nada a aprender com eles. No entanto, resolver esses problemas sintéticos pode levar você a aprender e aplicar partes da sua linguagem que talvez você nunca tenha explorado. Esse novo aprendizado pode fazer você resolver problemas do mundo real com mais eficiência ou mais expressividade.
Frequência de Letras em Paralelo é um exercício de dificuldade média na Trilha de Elixir do Exercism que traz uma quantidade surpreendente de lições interessantes. Para resolver esse problema com sucesso, sua solução deve ser executada em paralelo em vários processos worker. Alcançar paralelismo de verdade no Elixir é surpreendentemente fácil em comparação com outras linguagens, mas se você nunca escreveu código concorrente em Elixir, isso pode parecer um pouco assustador. Uma das coisas que você vai descobrir ao resolver este exercício é como o Elixir torna fácil escrever código que pode ser executado de forma concorrente ou paralela. Aplicar essas habilidades ao seu código pode ter um impacto significativo no desempenho das suas aplicações.
Este exercício pede que você implemente uma função, Frequency.frequency/2, que determina a frequência de letras em uma lista de strings. O cálculo deve ser feito em vários processos worker, definidos pelo argumento workers:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
Neste artigo, vamos explorar a concorrência no Elixir tornando concorrente uma solução sequencial que já funciona para este exercício. Mas, antes de mergulharmos no código, vamos reservar um momento para examinar o que "concorrência" e "paralelismo" realmente significam, e como alcançar os dois no Elixir em comparação com outras linguagens.
Concorrência e paralelismo
Concorrência e paralelismo são termos relacionados, mas não significam exatamente a mesma coisa. Um programa concorrente é aquele em que várias tarefas podem estar "em andamento", mas em um único instante apenas uma tarefa está sendo executada na CPU (por exemplo, executar uma tarefa enquanto outra espera por IO, como ler ou gravar no disco ou na rede). Por outro lado, um programa paralelo é capaz de executar várias tarefas ao mesmo tempo em vários núcleos de CPU.
Tanto a execução concorrente quanto a paralela podem dar aumentos significativos de velocidade, mas o quanto de ganho é possível, se houver algum, depende de muitos fatores. Há casos em que a concorrência ou o paralelismo nem sequer são possíveis: pode ser que a tarefa que você está tentando concluir não se preste à execução concorrente nem à paralela, ou que o runtime não ofereça suporte a elas. Se o seu caso permitir execução concorrente ou paralela, o quanto de ganho é possível depende em grande parte de a tarefa ser limitada por IO ou por CPU, e de haver mais de um núcleo de CPU disponível.
Apesar da quantidade de fatores envolvidos, existem algumas "regras práticas" para determinar se a concorrência ou o paralelismo é possível e quanto ganho esperar. Primeiro, a execução concorrente é possível em um único núcleo de CPU, mas a execução paralela não. Segundo, o paralelismo e a concorrência devem dar um ganho significativo a tarefas limitadas por IO, e o ganho deve ser praticamente o mesmo nos dois casos. Por fim, tarefas limitadas por CPU devem ter o mesmo desempenho (ou pior) quando executadas de forma concorrente, e em geral só é possível ganhar velocidade executando-as em paralelo em vários núcleos de CPU.
O cálculo de frequência de letras neste exercício é um exemplo de tarefa limitada por CPU, então, de acordo com as regras práticas acima, só deve ser possível ganhar velocidade fazendo o cálculo em paralelo em vários núcleos de CPU.
Concorrência e paralelismo no Elixir em comparação com outras linguagens
Muitas linguagens populares oferecem ferramentas para escrever código concorrente, mas alcançar o paralelismo costuma ser bem mais complexo e cheio de trade-offs.
Por exemplo, a concorrência é cidadã de primeira classe no JavaScript rodando no runtime Node.js, e as versões padrão das funções relacionadas a IO são quase sempre "assíncronas" (ou seja, concorrentes). Por exemplo, fs.ReadFile é uma função concorrente e a forma padrão de ler o conteúdo de um arquivo. Isso é ótimo, mas também tem suas desvantagens, na forma do inferno dos callbacks, ou da necessidade de Promises. Além disso, como o Node não distribui o tempo de CPU igualmente entre as tarefas, ainda é possível bloquear a execução com uma única tarefa intensiva em CPU. Paralelizar a execução no Node é possível, mas certamente não é fácil. Como o Node é single threaded, a única forma de alcançar o paralelismo é criar manualmente processos worker com o módulo cluster ou rodar várias instâncias do seu programa e implementar manualmente a comunicação entre elas.
O Python, ao contrário do Node, não é concorrente por padrão, mas oferece várias ferramentas para escrever código concorrente e paralelo. No entanto, cada opção tem trade-offs, e escolher uma não é necessariamente simples. Você pode usar o módulo threading e lidar com o fato de que o global interpreter lock (GIL) limita a execução a uma única thread por vez, tornando o paralelismo impossível. A outra opção é o módulo multiprocessing do Python, que contorna a limitação do GIL criando processos do sistema operacional (em vez de threads). Usar multiprocessing torna o paralelismo possível, mas tem a desvantagem de que processos do sistema operacional demoram mais para serem criados e consomem mais memória do que threads.
Escrever código concorrente e paralelo no Elixir é bem mais simples, já que o Elixir é concorrente no nível do runtime. A reputação do Elixir de escalabilidade massiva vem do fato de que ele roda na máquina virtual BEAM, que executa todo o código dentro de "processos" extremamente leves, que rodam concorrentemente dentro da VM. Os processos do BEAM têm custo insignificante para serem criados e usam quantidades minúsculas de memória, em comparação com as threads e processos do sistema operacional criados pelos módulos de concorrência do Python. Além disso, ao contrário do event loop do Node, a VM do BEAM tem escalonadores que alocam o tempo de CPU disponível a todos os processos, o que garante que uma única tarefa intensiva em CPU não consiga bloquear a execução dos outros processos.
Por causa dessa arquitetura, passar de executar processos de forma concorrente para executá-los em paralelo é só uma questão de adicionar mais núcleos de CPU. De fato, há muitos anos o BEAM ativa automaticamente os recursos de multiprocessamento simétrico (SMP) em sistemas com vários núcleos, o que permite que os escalonadores da VM aloquem tempo de CPU de todos os núcleos para os processos em execução. No Elixir, a concorrência não é apenas cidadã de primeira classe: também não há distinção entre código concorrente e código paralelo. Tudo o que você precisa fazer é escrever código concorrente, e a VM vai paralelizá-lo automaticamente e por padrão se houver mais de um núcleo de CPU disponível.
Escrevendo código Elixir concorrente com o módulo Task
Como mencionado acima, no Elixir a concorrência é alcançada distribuindo operações entre vários processos do BEAM. Você pode criar processos com muita facilidade usando funções como Kernel.spawn_link/1, mas é bem melhor usar as abstrações incrivelmente poderosas fornecidas pelo módulo Task:
O caso de uso mais comum de [Task] é converter código sequencial em código concorrente calculando um valor de forma assíncrona.
O módulo Task permite que você escreva código concorrente incrivelmente limpo no Elixir, sem o inferno dos callbacks e sem precisar de Promises.
Para este exercício, Task.async_stream/3 é uma ótima opção:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3 retorna um stream que executa a function fornecida de forma concorrente em cada item de enumerable. Por padrão, o número de processos criados (workers) é igual ao número de itens em enumerable. Isso nos dá uma forma direta de controlar o nível de paralelismo com o argumento workers (supondo que tenhamos núcleos de CPU suficientes). Tudo o que precisamos fazer é dividir a lista de letras no número certo de pedaços e usar Task.async_stream/3 para processar cada pedaço em um worker separado.
Tornando a função sequencial de frequência de letras concorrente
Vamos começar com uma implementação sequencial que funciona, tirada da minha solução:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
Podemos tornar a implementação acima concorrente fazendo o seguinte:
- Dividir a lista de grafemas retornada por
get_all_graphemes/1em um número de pedaços igual ao número deworkers - Processar cada pedaço com
count_letters/1em um worker usandoTask.async_stream/3 - Combinar os resultados de cada worker em um único resultado
Aqui está um diagrama das etapas acima:
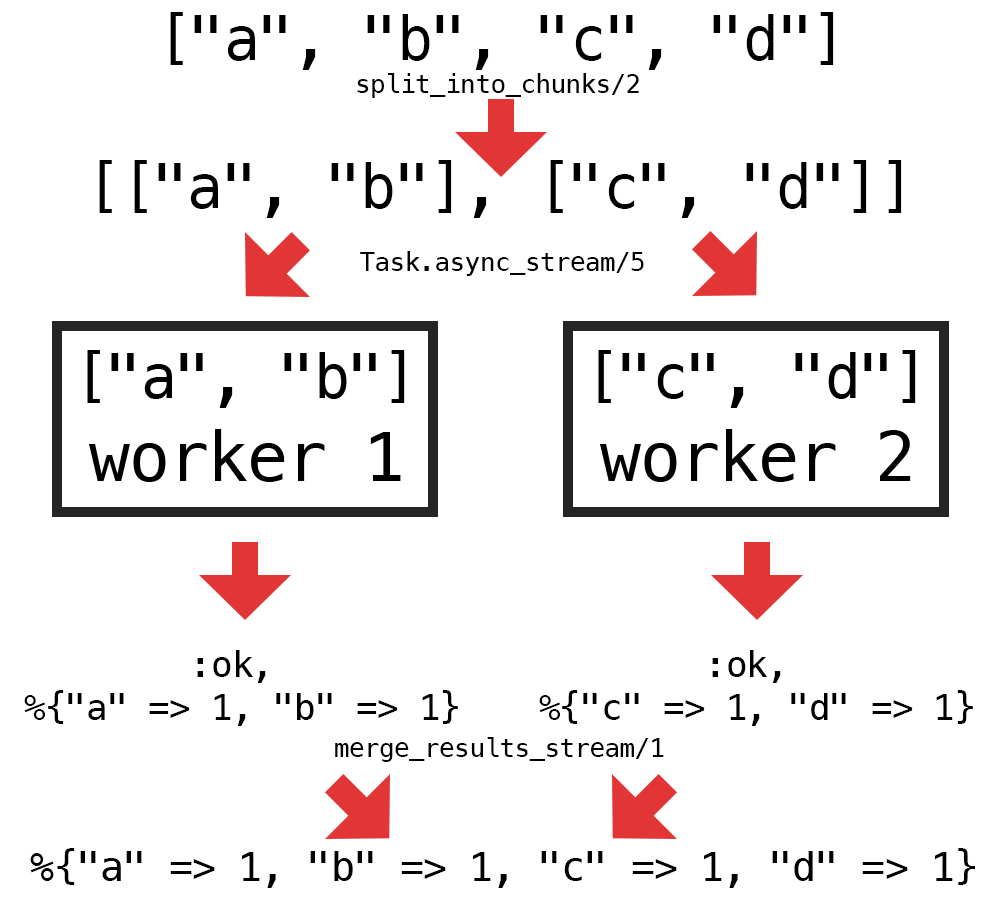
Só precisamos implementar 2 novas funções auxiliares para habilitar a lógica concorrente: uma para dividir os grafemas em pedaços (split_into_chunks/2) e outra para combinar o stream de resultados dos workers (merge_results/1). Aqui está uma forma de implementar essas funções auxiliares:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
Com essas 2 funções implementadas, tudo o que falta para fazer a função frequency/2 rodar de forma concorrente é adicionar chamadas às novas funções auxiliares e substituir a chamada direta a count_letters/1 por Task.async_stream/3:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
A função acima é uma implementação concorrente totalmente funcional e passa em todos os testes. Apesar de ser concorrente, o código se lê exatamente como código sequencial comum, o que demonstra o poder das abstrações fornecidas em Task.
A versão concorrente é de fato paralela?
Como mencionei antes neste artigo, não há distinção entre código concorrente e paralelo no Elixir. Se definirmos workers como um número maior que 1, e tivermos mais de um núcleo de CPU disponível, a VM do BEAM paraleliza automaticamente a execução dos processos criados.
Por padrão, o BEAM inicia um escalonador para cada núcleo de CPU (lógico) disponível. Você pode verificar o número de escalonadores que o BEAM iniciou com :erlang.system_info/1:
iex> :erlang.system_info(:schedulers_online)
8
Isso representa o número máximo de processos da VM que podem estar em execução ao mesmo tempo. Definir workers como um número maior que o número de escalonadores não aumenta o paralelismo e pode prejudicar o desempenho.
Conclusão
Converter o código de sequencial para concorrente acaba sendo bem mais fácil do que o esperado usando o módulo Task do Elixir. O código concorrente adiciona um pouco de complexidade extra ao dividir a lista de grafemas e combinar os resultados dos workers, mas o resultado final é surpreendentemente limpo.
Antes de resolver este problema do Exercism, eu tinha ouvido falar de Task, mas nunca o tinha usado. Depois de aplicá-lo na minha solução, agora o considero uma parte indispensável da minha caixa de ferramentas de Elixir.
Você pode usar essa nova ferramenta de muitas formas para tentar otimizar o desempenho das suas aplicações. A maioria das aplicações web é limitada por IO e, portanto, se beneficiaria da concorrência mesmo que haja apenas um único núcleo de CPU disponível. Uma forma bastante confiável de acelerar uma aplicação web é fazer requisições HTTP de forma concorrente:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
O código acima aplica Task.async_stream/3 para chamar todas as URLs da lista de forma concorrente, em vez de esperar cada requisição terminar antes de iniciar a próxima, o que deve dar um ganho significativo dependendo da duração de cada requisição.

