



































覺得這篇文章有幫助嗎?
分享出去吧!
這是 Percy Grunwald 的 Elixir 系列文章第二篇。別錯過第一篇:Elixir 中的 Unicode 比對。
Exercism 上的練習規模不大、是人為設計出來的,而且常常看似微不足道。你很容易覺得,經驗豐富的開發者根本沒什麼好從中學習的。不過,動手解這些人工設計的題目,往往會推著你去學習並運用自己從未探索過的語言特性。這些新學到的東西,能讓你用更有效率或更具表達力的方式解決真實世界的問題。
平行字母頻率是 Exercism 的 Elixir 軌道上一道中等難度的練習,裡面藏著多到令人意外的有趣課題。想順利解出這題,你的解法必須在多個工作行程中平行執行。相較於其他語言,在 Elixir 裡達成真正的平行出乎意料地容易;但如果你從沒在 Elixir 寫過併發程式,一開始可能會覺得有點嚇人。解這道練習的過程中,你會發現的其中一件事就是:Elixir 讓撰寫可併發或平行執行的程式變得有多容易。把這些技巧運用到自己的程式上,能對應用程式的效能帶來很大的影響。
這道練習要求你實作一個函式Frequency.frequency/2,用來計算字串陣列中的字母出現頻率。計算應該交由數個工作行程進行,數量由workers引數決定:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
在這篇文章裡,我們會把一份可運作的循序解法改成併發版本,藉此探索 Elixir 的併發。不過在跳進程式碼之前,先花點時間看看「併發」與「平行」到底是什麼意思,以及該怎麼在 Elixir 和其他語言中達成這兩者。
併發與平行
併發與平行是相關的詞,但意思並不完全相同。_併發_的程式可以同時有多個任務「進行中」,但在任何一個時間點,CPU 上只會有一個任務在執行(例如,執行某個任務時,另一個任務正在等待 IO,像是讀寫磁碟或網路)。相對地,_平行_的程式則能在多個 CPU 核心上_同時_執行多個任務。
併發與平行執行都能帶來明顯的速度提升,但實際能提升多少(如果有的話)取決於許多因素。有些情況下,甚至根本不可能做到併發或平行;可能是你想完成的任務本身不適合以併發或平行方式執行,也可能是執行環境不支援。如果你的情況_確實_能併發或平行執行,那麼能提升多少速度,主要取決於任務是 IO 密集還是 CPU 密集,以及可用的 CPU 核心是否超過 1 個。
儘管影響因素很多,要判斷併發或平行是否可行、以及該期待多少加速,還是有幾條「經驗法則」。首先,在單一 CPU 核心上可以做到併發執行,但做不到平行執行。其次,對 IO 密集的任務來說,平行與併發都應該能帶來明顯加速,而且兩者的加速幅度理論上差不多。最後,CPU 密集的任務以併發方式執行時,效能應該和平常一樣(甚至更慢);一般來說,只有在多個 CPU 核心上平行執行,速度才可能提升。
這道練習的字母頻率計算是 CPU 密集任務的例子,所以根據上面的經驗法則,只有在多個 CPU 核心上平行計算,才可能提升速度。
Elixir 與其他語言的併發與平行
許多熱門語言都提供工具讓你寫併發程式,但要達成平行通常複雜得多,而且充滿各種取捨。
舉例來說,在 Node.js 執行環境上執行的 JavaScript 中,併發是一等公民,而且與 IO 相關的函式預設版本幾乎都是「非同步」的(也就是併發)。例如,fs.ReadFile就是一個併發函式,也是讀取檔案內容的標準做法。這很棒,但也有缺點,例如回呼地獄,或是必須使用 Promise。此外,由於 Node 不會把 CPU 時間平均分配給各個任務,單一吃重 CPU 的任務仍然可能阻塞執行。在 Node 裡要讓執行平行化是可行的,但絕對不容易。由於 Node 是單執行緒的,要達成平行,唯一的辦法就是用cluster模組手動生成工作行程,或是同時執行多個程式實例,再自己實作它們之間的溝通。
Python 和 Node 不同,預設並非併發,但它提供了不少工具來撰寫併發與平行程式。不過每種選擇都有取捨,要挑哪一個並不見得簡單明瞭。你可以使用 threading模組,然後接受global interpreter lock (GIL)會限制同一時間只能有一個執行緒執行、因而無法達成平行這件事。另一個選擇是 Python 的 multiprocessing模組,它透過生成作業系統行程(而不是執行緒)來繞過 GIL 的限制。使用multiprocessing雖然能達成平行,但代價是作業系統行程的生成比執行緒慢,佔用的記憶體也更多。
在 Elixir 裡寫併發與平行程式就簡單多了,因為 Elixir 在執行環境層級就是併發的。Elixir 以能大規模擴展聞名,原因是它執行在 BEAM 虛擬機上;BEAM 會把所有程式碼放在極為輕量的「行程」中執行,而這些行程全都在虛擬機內併發運行。相較於 Python 的併發模組所生成的作業系統層級執行緒與行程,BEAM 行程的生成成本幾乎可以忽略,佔用的記憶體也極少。此外,與 Node 的事件迴圈不同,BEAM 虛擬機的排程器會把可用的 CPU 時間分配給所有行程,確保單一的 CPU 密集任務無法阻擋其他行程執行。
因為這樣的架構,要從併發執行行程變成平行執行,只是增加更多 CPU 核心的問題而已。事實上,BEAM 多年來都會在多核心系統上自動啟用對稱多處理(SMP)功能,讓虛擬機的排程器能把所有核心的 CPU 時間分配給正在執行的行程。在 Elixir 裡,併發不僅是一等公民,併發程式與平行程式之間甚至沒有任何區別。你只要寫出併發程式,只要有超過 1 個 CPU 核心可用,虛擬機就會_自動_且_預設_把它平行化。
用Task模組撰寫併發的 Elixir 程式
如前所述,在 Elixir 裡,併發是透過把運算分散到多個 BEAM 行程來達成的。你可以很輕鬆地用 Kernel.spawn_link/1這類函式生成行程,但更好的做法是使用 Task模組所提供的強大抽象:
[Task] 最常見的用途,就是非同步計算出一個值,藉此把循序程式改寫成併發程式。
Task模組讓你能在 Elixir 裡寫出_乾淨到難以置信_的併發程式,既沒有回呼地獄,也不需要Promises。
對這道練習來說,Task.async_stream/3是很好的選擇:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3會回傳一個串流,對enumerable中的每個項目併發執行給定的function。預設情況下,生成的行程數量(即 workers)等於enumerable中的項目數。這讓我們能用workers引數直接控制平行程度(前提是 CPU 核心夠多)。我們只要把字母陣列切成正確數量的區段,再用Task.async_stream/3讓每個區段在各自的工作行程中處理就行了。
讓循序的字母頻率函式變成併發
我們先從一份可運作的循序實作開始,這是我的解法:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
只要照著下列步驟,就能把上面的實作改成併發版本:
- 把
get_all_graphemes/1回傳的字素陣列,切成與workers數量相同的區段 - 用
Task.async_stream/3,讓每個區段在一個工作行程中以count_letters/1處理 - 把每個工作行程的結果合併成單一結果
下圖是上述步驟的示意圖:
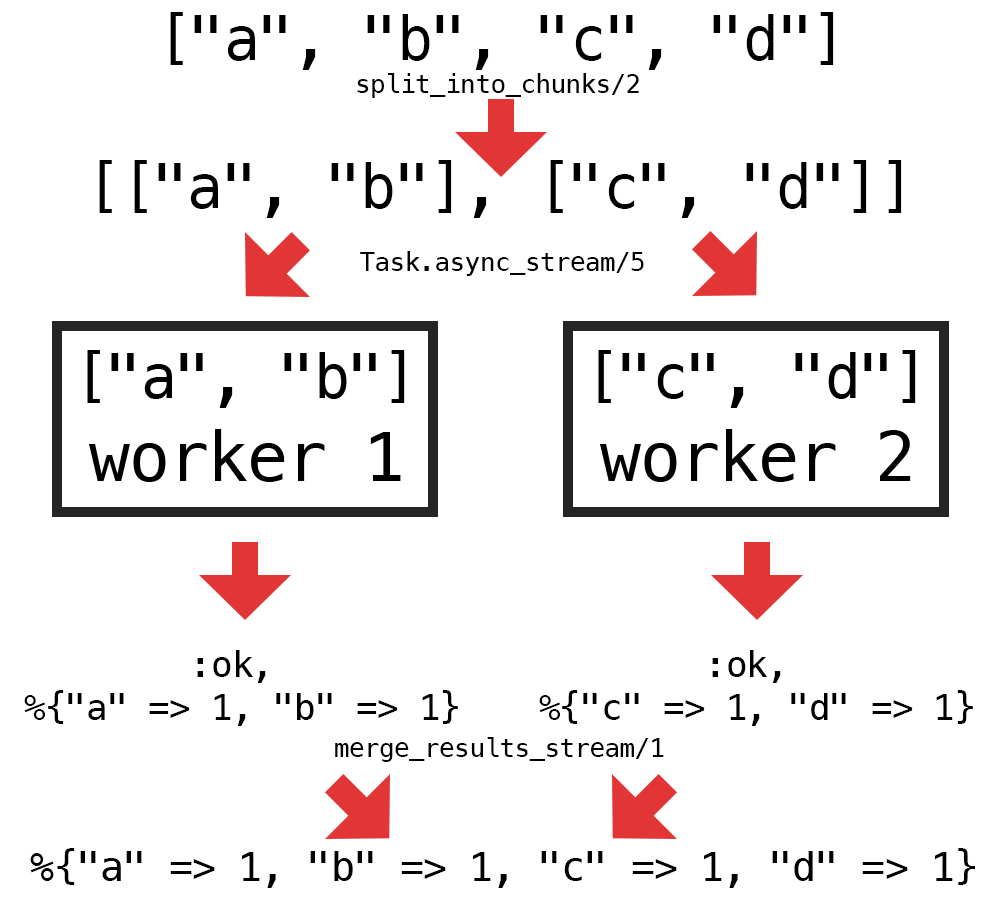
我們只需要實作 2 個新的輔助函式來實現併發邏輯:一個負責把字素切成區段(split_into_chunks/2),另一個負責合併來自各工作行程的結果stream(merge_results/1)。以下是實作這兩個輔助函式的其中一種方式:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
實作好這 2 個函式後,要讓frequency/2函式併發執行,剩下的工作就是加入對這兩個新輔助函式的呼叫,並把直接呼叫count_letters/1改成使用Task.async_stream/3:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
上面的函式是一份完全可運作的併發實作,而且能通過所有測試。雖然是併發程式,讀起來卻和一般的循序程式一模一樣,這正好展現了Task所提供抽象的威力。
併發版本真的平行嗎?
就像我在文章前面提到的,在 Elixir 裡,併發程式與平行程式並沒有區別。如果我們把workers設成大於 1 的數字,而且有超過 1 個 CPU 核心可用,BEAM 虛擬機就會自動把這些生成的行程平行執行。
預設情況下,BEAM 會為每個可用的(邏輯)CPU 核心啟動一個排程器。你可以用:erlang.system_info/1查看 BEAM 啟動了幾個排程器:
iex> :erlang.system_info(:schedulers_online)
8
這代表同一時間最多可以有幾個 VM 行程在執行。把workers設成_大於_排程器數量的數字,並不會提高平行程度,反而可能拖慢效能。
結語
用 Elixir 的Task模組把程式從循序改成併發,結果比預期容易得多。併發版本在切割字素陣列和合併各工作行程結果的部分多了一些複雜度,但最終的成果乾淨得令人驚訝。
在解這道 Exercism 練習之前,我聽過Task,卻從沒用過。把它用在解法裡之後,現在我會說它是我 Elixir 工具箱裡不可或缺的一部分。
你可以用這個新工具做很多事,試著最佳化應用程式的效能。大多數網頁應用程式都是 IO 密集的,因此即使只有一個 CPU 核心可用,也能從併發中獲益。想加速網頁應用程式,有一個相當可靠的方法:併發發出 HTTP 請求:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
上面的程式碼用 Task.async_stream/3併發呼叫陣列中的所有網址,而不是等每個請求完成後才發出下一個;視每個請求的耗時而定,這應該能帶來明顯的加速。

