



































Achas esta publicação útil?
Partilha-a!
Este é o segundo artigo da série de Percy Grunwald sobre Elixir. Não percas o primeiro artigo sobre correspondência de Unicode em Elixir.
Os exercícios no Exercism são pequenos, sintéticos e, muitas vezes, aparentemente triviais. É fácil imaginar que quem já tem experiência não teria nada a aprender com eles. No entanto, resolver estes problemas sintéticos pode levar-te a aprender e a aplicar partes da linguagem que estás a aprender que talvez ainda não tenhas explorado. Esta nova aprendizagem pode levar-te a resolver problemas do mundo real de forma mais eficiente ou mais expressiva.
O Parallel Letter Frequency é um exercício de dificuldade média na Track de Elixir do Exercism que desvenda um número surpreendente de lições interessantes. Para resolveres este problema com sucesso, a tua solução deve ser executada em paralelo em vários processos worker. Alcançar verdadeiro paralelismo em Elixir é surpreendentemente fácil em comparação com outras linguagens, mas, se nunca escreveste código concorrente em Elixir, pode parecer um pouco assustador. Uma das coisas que vais descobrir ao resolver este exercício é como o Elixir torna fácil escrever código que pode ser executado de forma concorrente ou em paralelo. Aplicar estas competências ao teu código pode ter um impacto significativo no desempenho das tuas aplicações.
Este exercício pede-te que implementes uma função, Frequency.frequency/2, que determina a frequência de letras numa lista de strings. O cálculo deve ser feito em vários processos worker, definidos pelo argumento workers:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
Neste artigo, vamos explorar a concorrência em Elixir, tornando concorrente uma solução sequencial funcional para este exercício. No entanto, antes de avançarmos para o código, vamos dedicar um momento a examinar o que significam, na verdade, "concorrência" e "paralelismo", e como alcançar ambos em Elixir vs. outras linguagens.
Concorrência e paralelismo
Concorrência e paralelismo são termos relacionados, mas não significam exatamente a mesma coisa. Um programa concorrente é aquele em que várias tarefas podem estar "em curso", mas, em qualquer momento, apenas uma tarefa está a ser executada na CPU (por exemplo, executar uma tarefa enquanto outra está à espera de IO, como ler ou escrever no disco ou numa rede). Por outro lado, um programa paralelo é capaz de executar várias tarefas ao mesmo tempo em vários núcleos de CPU.
Tanto a execução concorrente como a paralela podem dar aumentos de velocidade significativos, mas a quantidade de ganho possível, se houver algum, depende de muitos fatores. Há casos em que a concorrência ou o paralelismo não são sequer possíveis; pode acontecer que a tarefa que estás a tentar concluir não se preste a execução concorrente nem paralela, ou que o runtime não as suporte. Se o teu caso permitir execução concorrente ou paralela, a quantidade de ganho possível depende, em grande medida, de a tarefa estar limitada por IO ou pela CPU e de haver mais do que 1 núcleo de CPU disponível.
Apesar do número de fatores que contribuem, há algumas "regras práticas" para determinar se a concorrência ou o paralelismo são possíveis e quanto ganho de velocidade esperar. Em primeiro lugar, a execução concorrente é possível num único núcleo de CPU, mas a execução paralela não. Em segundo lugar, o paralelismo e a concorrência devem dar um ganho de velocidade significativo às tarefas limitadas por IO, e esse ganho deve ser nominalmente o mesmo para ambos. Por último, as tarefas limitadas pela CPU devem ter o mesmo desempenho (ou pior) quando executadas de forma concorrente, e, em geral, só é possível aumentar a velocidade quando são executadas em paralelo por vários núcleos de CPU.
O cálculo da frequência de letras neste exercício é um exemplo de uma tarefa limitada pela CPU, por isso, de acordo com as regras práticas acima, só deve ser possível aumentar a velocidade fazendo o cálculo em paralelo em vários núcleos de CPU.
Concorrência e paralelismo em Elixir vs. outras linguagens
Muitas linguagens populares dão-te ferramentas para escrever código concorrente, mas alcançar o paralelismo é habitualmente muito mais complexo e cheio de contrapartidas.
Por exemplo, a concorrência é um cidadão de primeira classe no JavaScript a correr no runtime Node.js, e as versões predefinidas das funções relacionadas com IO são quase sempre "assíncronas" (ou seja, concorrentes). Por exemplo, fs.ReadFile é uma função concorrente e a forma normal de ler o conteúdo de um ficheiro. Isto é ótimo, mas também tem as suas desvantagens, na forma de callback hell ou da necessidade de Promises. Além disso, como o Node não distribui o tempo de CPU equitativamente pelas tarefas, continua a ser possível bloquear a execução com uma única tarefa intensiva em CPU. Paralelizar a execução no Node é possível, mas certamente não é fácil. Dado que o Node é single threaded, a única forma de alcançar paralelismo é criar manualmente processos worker com o módulo cluster ou executar várias instâncias do teu programa e implementar manualmente a comunicação entre elas.
O Python, ao contrário do Node, não é concorrente por predefinição, mas dá-te várias ferramentas para escrever código concorrente e paralelo. No entanto, cada opção tem contrapartidas e escolher uma não é necessariamente simples. Podes usar o módulo threading e lidar com o facto de o global interpreter lock (GIL) limitar a execução a uma única thread de cada vez, tornando o paralelismo impossível. A outra opção é o módulo multiprocessing do Python, que contorna a limitação do GIL ao criar processos do sistema operativo (em vez de threads). Usar multiprocessing torna o paralelismo possível, mas tem a contrapartida de os processos do sistema operativo serem mais lentos a criar e usarem mais memória do que as threads.
Escrever código concorrente e paralelo em Elixir é muito mais simples, uma vez que o Elixir é concorrente ao nível do runtime. A reputação de enorme escalabilidade do Elixir vem do facto de correr na máquina virtual BEAM, que executa todo o código dentro de "processos" extremamente leves que correm todos em simultâneo dentro da VM. Os processos do BEAM têm um custo de criação negligenciável e usam quantidades mínimas de memória em comparação com as threads e os processos ao nível do sistema operativo criados pelos módulos de concorrência do Python. Além disso, ao contrário do event loop do Node, a VM do BEAM tem agendadores que atribuem o tempo de CPU disponível por todos os processos, o que garante que uma única tarefa intensiva em CPU não pode bloquear a execução dos outros processos.
Devido a esta arquitetura, passar de executar processos de forma concorrente para os executar em paralelo é apenas uma questão de adicionar mais núcleos de CPU. Com efeito, há já muitos anos que o BEAM ativa automaticamente as capacidades de Symmetric Multiprocessing (SMP) em sistemas com vários núcleos, o que permite aos agendadores da VM atribuir aos processos em execução tempo de CPU de todos os núcleos. Em Elixir, não só a concorrência é um cidadão de primeira classe, como não há distinção entre código concorrente e código paralelo. Tudo o que precisas de fazer é escrever código concorrente e a VM vai paralelizá-lo automaticamente e por predefinição se houver mais do que 1 núcleo de CPU disponível.
Escrever código Elixir concorrente com o módulo Task
Como referido acima, em Elixir a concorrência consegue-se distribuindo operações por vários processos do BEAM. Podes criar processos com muita facilidade com funções como Kernel.spawn_link/1, mas é muito melhor usares as abstrações incrivelmente poderosas fornecidas pelo módulo Task:
O caso de uso mais comum do [Task] é converter código sequencial em código concorrente, calculando um valor de forma assíncrona.
O módulo Task permite-te escrever código concorrente inacreditavelmente limpo em Elixir, sem callback hell e sem necessidade de Promises.
Para este exercício, Task.async_stream/3 é uma excelente opção:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3 devolve um stream que executa a function dada de forma concorrente em cada item de enumerable. Por predefinição, o número de processos criados (workers) é igual ao número de itens em enumerable. Isto dá-nos uma forma simples de controlar o nível de paralelismo com o argumento workers (partindo do princípio de que temos núcleos de CPU suficientes). Tudo o que precisamos de fazer é dividir a lista de letras no número correto de blocos e usar Task.async_stream/3 para processar cada bloco num worker separado.
Tornar a função sequencial de frequência de letras concorrente
Vamos começar com uma implementação sequencial funcional da minha solução:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
Podemos tornar concorrente a implementação acima fazendo o seguinte:
- Dividir a lista de grafemas devolvida por
get_all_graphemes/1num número de blocos igual ao número deworkers - Processar cada bloco com
count_letters/1num worker, usandoTask.async_stream/3 - Combinar os resultados de cada worker num único resultado
Aqui está um diagrama dos passos acima:
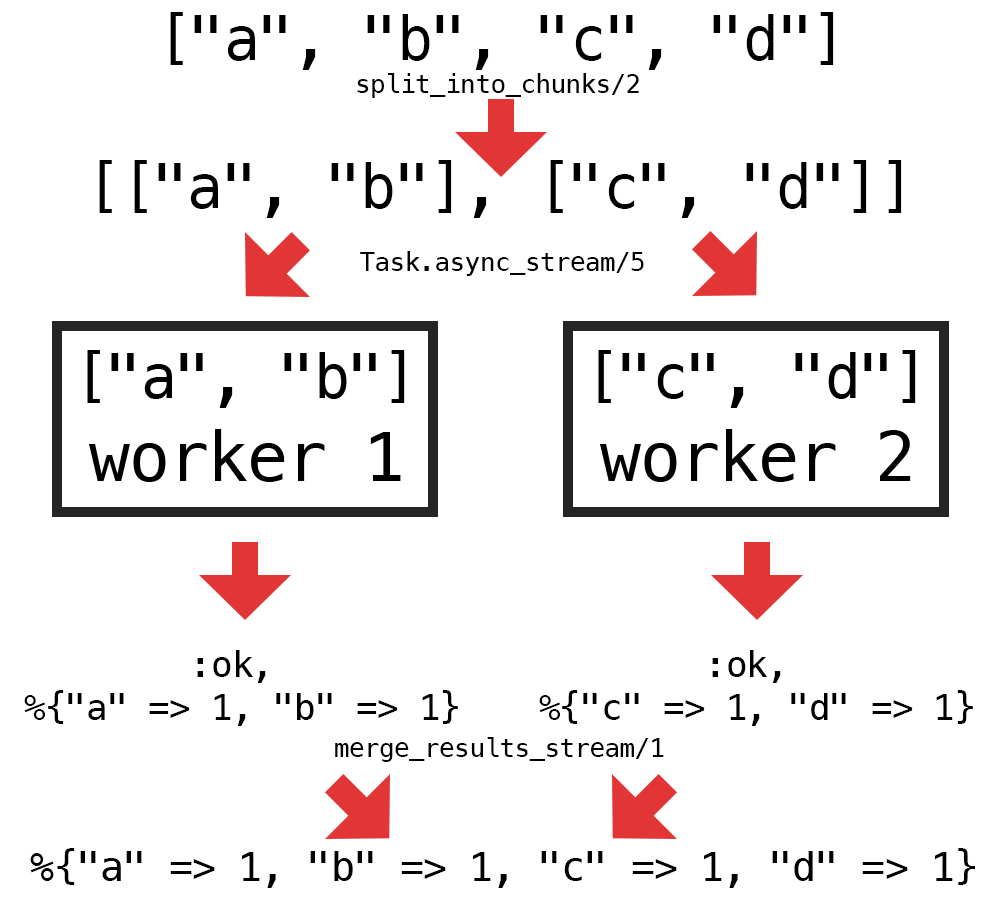
Só precisamos de implementar 2 novas funções auxiliares para ativar a lógica concorrente: uma para dividir os grafemas em blocos (split_into_chunks/2) e outra para combinar o stream de resultados dos workers (merge_results/1). Aqui está uma forma de implementar essas funções auxiliares:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
Com essas 2 funções implementadas, tudo o que falta fazer para tornar concorrente a função frequency/2 é adicionar chamadas às novas funções auxiliares e substituir a chamada direta a count_letters/1 por Task.async_stream/3:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
A função acima é uma implementação concorrente totalmente funcional e passa em todos os testes. Apesar de ser concorrente, o código lê-se exatamente como código sequencial normal, o que demonstra o poder das abstrações fornecidas em Task.
A versão concorrente é realmente paralela?
Como referi antes neste artigo, não há distinção entre código concorrente e código paralelo em Elixir. Se definirmos workers como um número maior do que 1 e tivermos mais do que 1 núcleo de CPU disponível, a VM do BEAM paraleliza automaticamente a execução dos processos criados.
Por predefinição, o BEAM inicia um agendador para cada núcleo de CPU (lógico) disponível. Podes verificar o número de agendadores que o BEAM iniciou com :erlang.system_info/1:
iex> :erlang.system_info(:schedulers_online)
8
Isto representa o número máximo de processos da VM que podem estar a ser executados ao mesmo tempo. Definir workers como um número maior do que o número de agendadores não aumenta o paralelismo e pode prejudicar o desempenho.
Conclusão
Converter o código de sequencial para concorrente revela-se muito mais fácil do que o esperado usando o módulo Task do Elixir. O código concorrente acrescenta alguma complexidade extra na divisão da lista de grafemas e na combinação dos resultados dos workers, mas o resultado final é surpreendentemente limpo.
Antes de resolver este problema do Exercism, tinha ouvido falar de Task, mas nunca o tinha usado. Depois de o aplicar na minha solução, considero-o agora uma parte indispensável da minha caixa de ferramentas de Elixir.
Podes usar esta nova ferramenta de muitas formas para tentar otimizar o desempenho das tuas aplicações. A maioria das aplicações web está limitada por IO e, por isso, beneficiaria da concorrência mesmo que houvesse apenas um único núcleo de CPU disponível. Uma forma bastante fiável de acelerar uma aplicação web é fazer pedidos HTTP de forma concorrente:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
O código acima aplica Task.async_stream/3 para chamar todos os URLs da lista de forma concorrente, em vez de esperar que cada pedido termine antes de iniciar o seguinte, o que deverá dar um ganho de velocidade significativo, dependendo da duração de cada pedido.

