



































この記事は役に立ちましたか?
ぜひ周りにシェアしましょう!
これはPercy GrunwaldによるElixirシリーズの第2回です。ElixirにおけるUnicodeマッチングの第1回もぜひお読みください。
Exercismの演習は小さく、人工的に作られ、しばしば取るに足らないように見えます。経験豊富なエンジニアなら学ぶことは何もないだろう、と思ってしまいがちです。しかし、こうした人工的な問題を解くことで、これまで触れてこなかった言語の部分を学び、実際に使うことにつながります。そうして得た学びは、現実世界の問題をより効率的に、あるいはより表現豊かに解く助けになるのです。
並列文字頻度は、ExercismのElixirトラックにある中級難易度の演習で、驚くほど多くの興味深い学びが詰まっています。この問題を正しく解くには、解答が複数のワーカープロセスで並列に実行される必要があります。Elixirで真の並列性を実現するのは、他の言語に比べて驚くほど簡単ですが、Elixirで並行コードを書いたことがない人には、少し難しく感じられるかもしれません。この演習を解く中で気づくことの1つは、Elixirでは並行にも並列にも実行できるコードをいかに簡単に書けるか、ということです。こうしたスキルを自分のコードに活かせば、アプリケーションのパフォーマンスに大きな影響を与えられます。
この演習では、文字列のリストに含まれる文字の頻度を求める関数Frequency.frequency/2を実装します。計算は、workers引数で指定された数のワーカープロセスで行う必要があります。
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
この記事では、この演習の動作する逐次的な解答を並行なものに変えながら、Elixirにおける並行処理を見ていきます。ただ、コードに入る前に、「並行」と「並列」が実際には何を意味するのか、そしてElixirと他の言語ではそれぞれをどう実現するのかを、少し見てみましょう。
並行と並列
並行と並列は関係する用語ですが、まったく同じ意味ではありません。_並行_なプログラムとは、複数のタスクが「進行中」になり得るものの、ある一時点でCPU上で実行されているタスクは1つだけであるものを指します(たとえば、1つのタスクを実行している間に、別のタスクがディスクやネットワークへの読み書きといったIOを待っている状態です)。一方、_並列_なプログラムは、複数のCPUコア上で複数のタスクを_同時に_実行できます。
並行実行も並列実行も、大きな速度向上をもたらすことがありますが、どれだけ高速化できるかは(そもそも可能だとしても)多くの要因に左右されます。並行も並列も不可能な場合さえあります。解こうとしているタスクが並行実行にも並列実行にも向いていなかったり、ランタイムがそれらをサポートしていなかったりするのです。もし並行実行や並列実行が_可能_なら、どれだけ高速化できるかは、そのタスクがIOバウンドかCPUバウンドか、そして利用できるCPUコアが1つより多いかどうかに大きく左右されます。
要因が多いとはいえ、並行や並列が可能かどうか、そしてどれだけ高速化が期待できるかを判断するための「経験則」がいくつかあります。まず、並行実行は1つのCPUコアでも可能ですが、並列実行はできません。次に、並列も並行もIOバウンドのタスクには大きな速度向上をもたらし、その度合いは名目上同じはずです。最後に、CPUバウンドのタスクを並行に実行しても性能は同じ(あるいは遅く)なり、一般に速度が向上するのは複数のCPUコアで並列に実行したときだけです。
この演習の文字の頻度の計算はCPUバウンドのタスクの一例なので、上の経験則に従えば、複数のCPUコアで計算を並列に行ったときにだけ速度が向上するはずです。
Elixirと他の言語における並行と並列
多くの人気言語には並行コードを書くためのツールが用意されていますが、並列性を実現するのはたいていずっと複雑で、トレードオフもたくさんあります。
たとえば、Node.jsランタイム上で動くJavaScriptでは、並行性は第一級の機能として扱われています。IOに関連する関数は、デフォルトのものがほとんど常に「非同期」(つまり並行)です。たとえばfs.ReadFileは並行関数で、ファイルの内容を読み込む標準的な方法です。これは素晴らしいことですが、コールバック地獄やPromisesの必要性という欠点もあります。また、Nodeはタスク間でCPU時間を均等に割り当てないため、1つのCPU負荷の高いタスクで実行が止まってしまう可能性があります。Nodeで実行を並列化することは可能ですが、決して簡単ではありません。Nodeはシングルスレッドなので、並列性を実現する唯一の方法は、clusterモジュールでワーカープロセスを手動でforkするか、プログラムの複数のインスタンスを実行してそれらの間の通信を手動で実装することです。
PythonはNodeとは違い、デフォルトでは並行ではありませんが、並行コードと並列コードを書くためのツールをいくつも提供しています。ただし、どの選択肢にもトレードオフがあり、1つを選ぶのは必ずしも簡単ではありません。threadingモジュールを使うと、global interpreter lock (GIL)が実行を一度に1つのスレッドに制限するため並列性が実現できない、という事実と向き合うことになります。もう1つの選択肢はPythonのmultiprocessingモジュールで、これは(スレッドではなく)OSプロセスを生成することでGILの制限を回避します。multiprocessingを使えば並列性は実現できますが、OSプロセスはスレッドより生成に時間がかかり、メモリも多く使うというトレードオフがあります。
Elixirで並行コードと並列コードを書くのはもっと簡単です。Elixirはランタイムのレベルで並行だからです。Elixirが大規模なスケーラビリティに強いと評判なのは、BEAM仮想マシン上で動作することが理由です。BEAMはすべてのコードを、VM内で並行に動く非常に軽量な「プロセス」の中で実行します。BEAMのプロセスは生成コストがごくわずかで、Pythonの並行モジュールが生成するOSレベルのスレッドやプロセスに比べて使うメモリもごくわずかです。また、Nodeのイベントループとは対照的に、BEAM VMにはスケジューラーがあり、利用可能なCPU時間をすべてのプロセスに割り当てるため、1つのCPU負荷の高いタスクが他のプロセスの実行を妨げることはありません。
このアーキテクチャのおかげで、プロセスを並行に実行することから並列に実行することへの移行は、CPUコアを増やすだけで済みます。実際、BEAMは何年も前からマルチコアシステム上で対称型マルチプロセッシング(SMP)機能を自動的に有効にしており、これによりVMのスケジューラーがすべてのコアからCPU時間を実行中のプロセスに割り当てられます。Elixirでは、並行性が第一級であるだけでなく、並行コードと並列コードの区別がありません。並行コードを書くだけで、利用できるCPUコアが1つより多ければ、VMが_自動的に_、そして_デフォルトで_それを並列化してくれます。
Taskモジュールで並行なElixirコードを書く
前述のとおり、Elixirでは複数のBEAMプロセスに処理を分散することで並行性を実現します。Kernel.spawn_link/1のような関数でプロセスを生成するのはとても簡単ですが、Taskモジュールが提供する強力な抽象化を使うほうがずっとよいでしょう。
[Task]の最も一般的な用途は、値を非同期に計算することで、逐次的なコードを並行なコードに変えることです。
Taskモジュールを使えば、Elixirで_信じられないほどクリーンな_並行コードを書けます。コールバック地獄もPromisesも必要ありません。
この演習では、Task.async_stream/3がうってつけです。
async_stream(enumerable, function, options \\ [])
Task.async_stream/3は、enumerableの各要素に対して与えられたfunctionを並行に実行するストリームを返します。デフォルトでは、生成されるプロセス(ワーカー)の数はenumerableの要素数と同じです。これにより、workers引数で並列度を簡単に制御できます(十分な数のCPUコアがあればの話ですが)。あとは、文字のリストを正しい数のチャンクに分割し、Task.async_stream/3で各チャンクを別々のワーカーで処理するだけです。
逐次的な文字頻度関数を並行にする
まずは、私の解答にある、動作する逐次的な実装から始めましょう。
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
上の実装は、次のようにすると並行にできます。
-
get_all_graphemes/1が返す書記素のリストを、workersの数と同じ数のチャンクに分割する -
Task.async_stream/3を使って、各チャンクをワーカー内でcount_letters/1で処理する - 各ワーカーの結果を1つの結果にマージする
上の手順を図にしたものです。
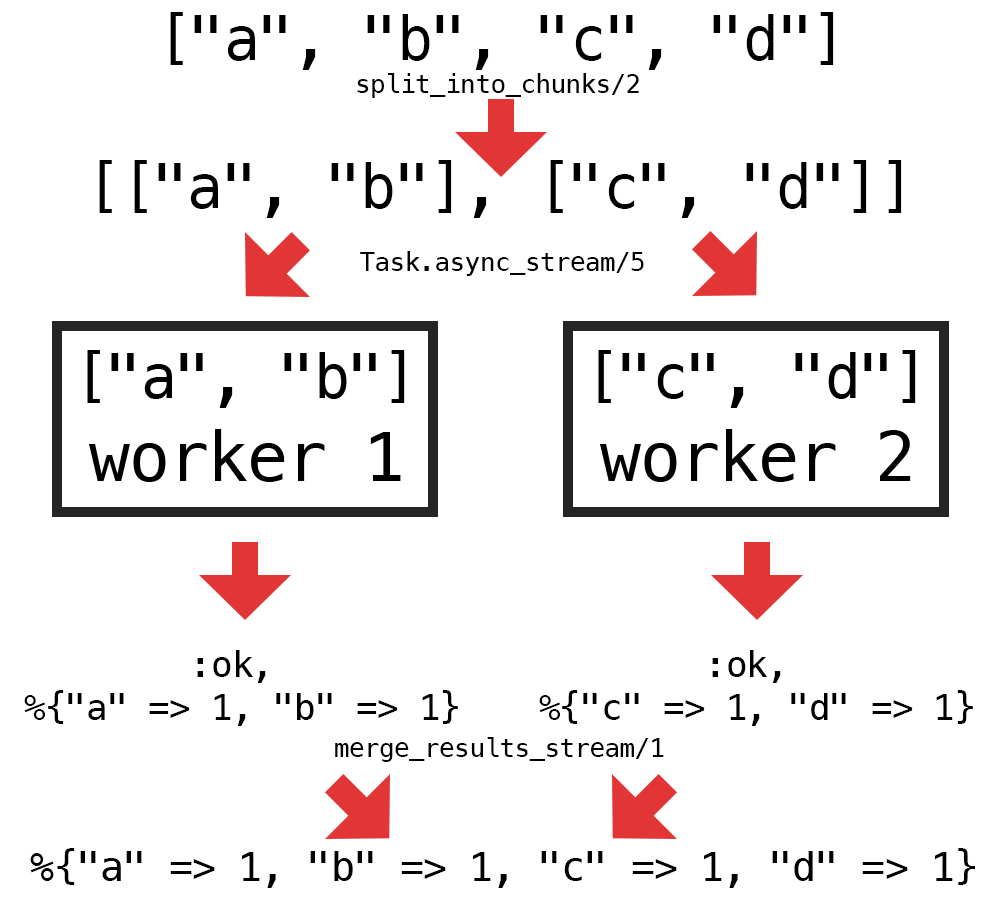
並行のロジックを実現するには、新しいヘルパー関数を2つ実装するだけです。1つは書記素をチャンクに分割するもの(split_into_chunks/2)、もう1つはワーカーからの結果のstreamをマージするもの(merge_results/1)です。これらのヘルパー関数の実装例を紹介します。
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
この2つの関数を実装すれば、frequency/2関数を並行に実行するために残っているのは、新しいヘルパー関数の呼び出しを追加し、count_letters/1への直接の呼び出しをTask.async_stream/3に置き換えることだけです。
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
上の関数は完全に動作する並行実装で、すべてのテストに合格します。並行であるにもかかわらず、コードは通常の逐次コードとまったく同じように読めます。これはTaskが提供する抽象化の力を見せてくれます。
並行版は本当に並列なのか?
記事の前半でも触れましたが、Elixirでは並行コードと並列コードの区別がありません。workersを1より大きい数に設定し、利用できるCPUコアが1つより多ければ、BEAM VMが生成されたプロセスの実行を自動的に並列化します。
デフォルトでは、BEAMは利用可能なCPUコア(論理コア)ごとにスケジューラーを起動します。BEAMが起動したスケジューラーの数は:erlang.system_info/1で確認できます。
iex> :erlang.system_info(:schedulers_online)
8
これは、同時に実行できるVMプロセスの最大数を表します。workersをスケジューラーの数_より多い_数に設定しても並列度は上がらず、パフォーマンスが悪化するおそれがあります。
まとめ
ElixirのTaskモジュールを使えば、コードを逐次から並行に変えるのは予想よりもずっと簡単です。並行コードでは、書記素のリストの分割とワーカーの結果の統合という点で少し複雑さが増しますが、出来上がったコードは驚くほどすっきりしています。
このExercismの問題を解く前、私はTaskのことは聞いたことがありましたが、使ったことはありませんでした。自分の解答で使ってみてからは、私のElixirの道具箱に欠かせないものだと考えるようになりました。
この新しいツールは、アプリケーションのパフォーマンスを最適化するためにいろいろな形で使えます。ほとんどのWebアプリケーションはIOバウンドなので、利用できるCPUコアが1つしかなくても、並行性の恩恵を受けられます。Webアプリケーションを高速化するかなり確実な方法の1つは、HTTPリクエストを並行に送ることです。
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
上のコードはTask.async_stream/3を使って、リスト内のすべてのURLを並行に呼び出します。次のリクエストを始める前に各リクエストの完了を待つのとは対照的で、各リクエストの所要時間に応じて大きな高速化が期待できます。

