



































¿Te ha resultado útil esta entrada?
¡Compártela!
Esta es la segunda parte de la serie de Percy Grunwald sobre Elixir. No te pierdas el primer artículo sobre la coincidencia de Unicode en Elixir.
Los ejercicios de Exercism son pequeños, sintéticos y, a menudo, aparentemente triviales. Es fácil imaginar que los desarrolladores con experiencia no tendrían nada que aprender de ellos. Sin embargo, resolver estos problemas sintéticos puede impulsarte a aprender y aplicar partes de tu lenguaje que quizá no hayas explorado. Este nuevo aprendizaje puede llevarte a resolver problemas del mundo real de forma más eficiente o más expresiva.
Frecuencia de letras en paralelo es un ejercicio de dificultad media del track de Elixir de Exercism que desglosa una cantidad sorprendente de lecciones interesantes. Para resolverlo con éxito, tu solución debe ejecutarse en paralelo en varios procesos worker. Lograr un paralelismo real en Elixir es sorprendentemente fácil en comparación con otros lenguajes, pero si nunca has escrito código concurrente en Elixir, puede parecer un poco abrumador. Una de las cosas que descubrirás al resolver este ejercicio es lo fácil que Elixir hace escribir código que puede ejecutarse de forma concurrente o en paralelo. Aplicar estas habilidades a tu código puede tener un impacto significativo en el rendimiento de tus aplicaciones.
Este ejercicio te pide que implementes una función, Frequency.frequency/2, que determina la frecuencia de letras en un array de strings. El cálculo debe realizarse en varios procesos worker, en un número fijado por el argumento workers:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
En este artículo, vamos a explorar la concurrencia en Elixir convirtiendo en concurrente una solución secuencial que funciona para este ejercicio. Pero antes de meternos de lleno en el código, dediquemos un momento a examinar qué significan realmente «concurrencia» y «paralelismo» y cómo lograr ambos en Elixir frente a otros lenguajes.
Concurrencia y paralelismo
La concurrencia y el paralelismo son términos relacionados, pero no significan exactamente lo mismo. Un programa concurrente es aquel en el que varias tareas pueden estar «en curso», pero en un momento dado solo una tarea se está ejecutando en la CPU (por ejemplo, ejecutar una tarea mientras otra espera a una operación de E/S, como leer o escribir en el disco o en la red). Por otro lado, un programa paralelo es capaz de ejecutar varias tareas al mismo tiempo en varios núcleos de CPU.
Tanto la ejecución concurrente como la paralela pueden aportar aumentos de velocidad significativos, pero la magnitud de esa mejora, si es que la hay, depende de muchos factores. Hay casos en los que la concurrencia o el paralelismo ni siquiera son posibles; puede que la tarea que intentas completar no se preste a una ejecución concurrente o paralela, o que el runtime no los admita. Si tu caso sí permite una ejecución concurrente o paralela, la mejora posible depende en gran medida de si la tarea está limitada por E/S o por la CPU, y de si hay más de 1 núcleo de CPU disponible.
A pesar del número de factores que influyen, hay algunas «reglas generales» para determinar si la concurrencia o el paralelismo son posibles y cuánta mejora de velocidad cabe esperar. En primer lugar, la ejecución concurrente es posible en un solo núcleo de CPU, pero la paralela no. En segundo lugar, el paralelismo y la concurrencia deberían aportar una mejora de velocidad significativa a las tareas limitadas por E/S, y esa mejora debería ser nominalmente la misma en ambos casos. Por último, las tareas limitadas por la CPU deberían rendir igual (o peor) cuando se ejecutan de forma concurrente, y, por lo general, solo es posible aumentar la velocidad cuando se ejecutan en paralelo en varios núcleos de CPU.
El cálculo de la frecuencia de letras de este ejercicio es un ejemplo de tarea limitada por la CPU, así que, según las reglas generales anteriores, solo debería ser posible aumentar la velocidad haciendo el cálculo en paralelo en varios núcleos de CPU.
Concurrencia y paralelismo en Elixir frente a otros lenguajes
Muchos lenguajes populares te ofrecen herramientas para escribir código concurrente, pero lograr el paralelismo suele ser mucho más complejo y estar lleno de compromisos.
Por ejemplo, la concurrencia es un ciudadano de primera clase en JavaScript ejecutándose sobre el runtime de Node.js, y las versiones predeterminadas de las funciones relacionadas con la E/S son casi siempre «asíncronas» (es decir, concurrentes). Por ejemplo, fs.ReadFile es una función concurrente y la forma estándar de leer el contenido de un fichero. Esto es genial, pero también tiene sus inconvenientes en forma de infierno de callbacks o la necesidad de Promises. Además, como Node no reparte el tiempo de CPU por igual entre las tareas, sigue siendo posible bloquear la ejecución con una sola tarea intensiva en CPU. Paralelizar la ejecución en Node es posible, pero desde luego no es fácil. Dado que Node es monohilo, la única forma de lograr el paralelismo es crear manualmente procesos worker con el módulo cluster o ejecutar varias instancias de tu programa e implementar manualmente la comunicación entre ellas.
Python, a diferencia de Node, no es concurrente de forma predeterminada, pero sí te ofrece varias herramientas para escribir código concurrente y paralelo. Sin embargo, cada opción tiene sus compromisos y elegir una no es necesariamente sencillo. Podrías usar el módulo threading y lidiar con el hecho de que el global interpreter lock (GIL) limita la ejecución a un solo hilo a la vez, lo que hace imposible el paralelismo. La otra opción es el módulo multiprocessing de Python, que sortea la limitación del GIL creando procesos del sistema operativo (en lugar de hilos). Usar multiprocessing hace posible el paralelismo, pero tiene el compromiso de que los procesos del sistema operativo tardan más en crearse y usan más memoria que los hilos.
Escribir código concurrente y paralelo en Elixir es mucho más sencillo, ya que Elixir es concurrente a nivel del runtime. La reputación de Elixir de ofrecer una escalabilidad enorme se debe a que se ejecuta sobre la máquina virtual BEAM, que ejecuta todo el código dentro de «procesos» extremadamente ligeros que se ejecutan de forma concurrente dentro de la VM. Los procesos de la BEAM tienen un coste de creación insignificante y usan cantidades ínfimas de memoria en comparación con los hilos y procesos a nivel del sistema operativo que crean los módulos de concurrencia de Python. Además, a diferencia del bucle de eventos de Node, la VM de la BEAM tiene planificadores que asignan el tiempo de CPU disponible a todos los procesos, lo que garantiza que una sola tarea intensiva en CPU no pueda bloquear la ejecución de los demás procesos.
Debido a esta arquitectura, pasar de ejecutar procesos de forma concurrente a hacerlo en paralelo es solo cuestión de añadir más núcleos de CPU. De hecho, desde hace muchos años la BEAM activa automáticamente las capacidades de multiprocesamiento simétrico (SMP) en sistemas con varios núcleos, lo que permite a los planificadores de la VM asignar a los procesos en ejecución el tiempo de CPU de todos los núcleos. En Elixir, no solo la concurrencia es un ciudadano de primera clase, sino que no hay ninguna distinción entre código concurrente y paralelo. Lo único que tienes que hacer es escribir código concurrente, y la VM lo paralelizará automáticamente y de forma predeterminada si hay más de 1 núcleo de CPU disponible.
Escribir código concurrente en Elixir con el módulo Task
Como se ha mencionado antes, en Elixir la concurrencia se logra distribuyendo operaciones entre varios procesos de la BEAM. Puedes crear procesos con mucha facilidad usando funciones como Kernel.spawn_link/1, pero te irá mucho mejor si usas las asombrosamente potentes abstracciones que ofrece el módulo Task:
El caso de uso más común de [Task] es convertir código secuencial en código concurrente calculando un valor de forma asíncrona.
El módulo Task te permite escribir código concurrente increíblemente limpio en Elixir, sin infierno de callbacks ni necesidad de Promises.
Para este ejercicio, Task.async_stream/3 es una opción excelente:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3 devuelve un stream que ejecuta la function dada de forma concurrente sobre cada elemento de enumerable. De forma predeterminada, el número de procesos creados (los workers) es igual al número de elementos de enumerable. Esto nos da una forma sencilla de controlar el nivel de paralelismo con el argumento workers (suponiendo que tengamos suficientes núcleos de CPU). Lo único que tenemos que hacer es dividir el array de letras en el número correcto de fragmentos y usar Task.async_stream/3 para procesar cada fragmento en un worker distinto.
Convertir en concurrente la función secuencial de frecuencia de letras
Empecemos con una implementación secuencial que funciona, tomada de mi solución:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
Podemos hacer concurrente la implementación anterior de la siguiente manera:
- Dividir el array de grafemas que devuelve
get_all_graphemes/1en un número de fragmentos igual al número deworkers - Procesar cada fragmento con
count_letters/1en un worker usandoTask.async_stream/3 - Combinar los resultados de cada worker en un único resultado
Aquí tienes un diagrama de los pasos anteriores:
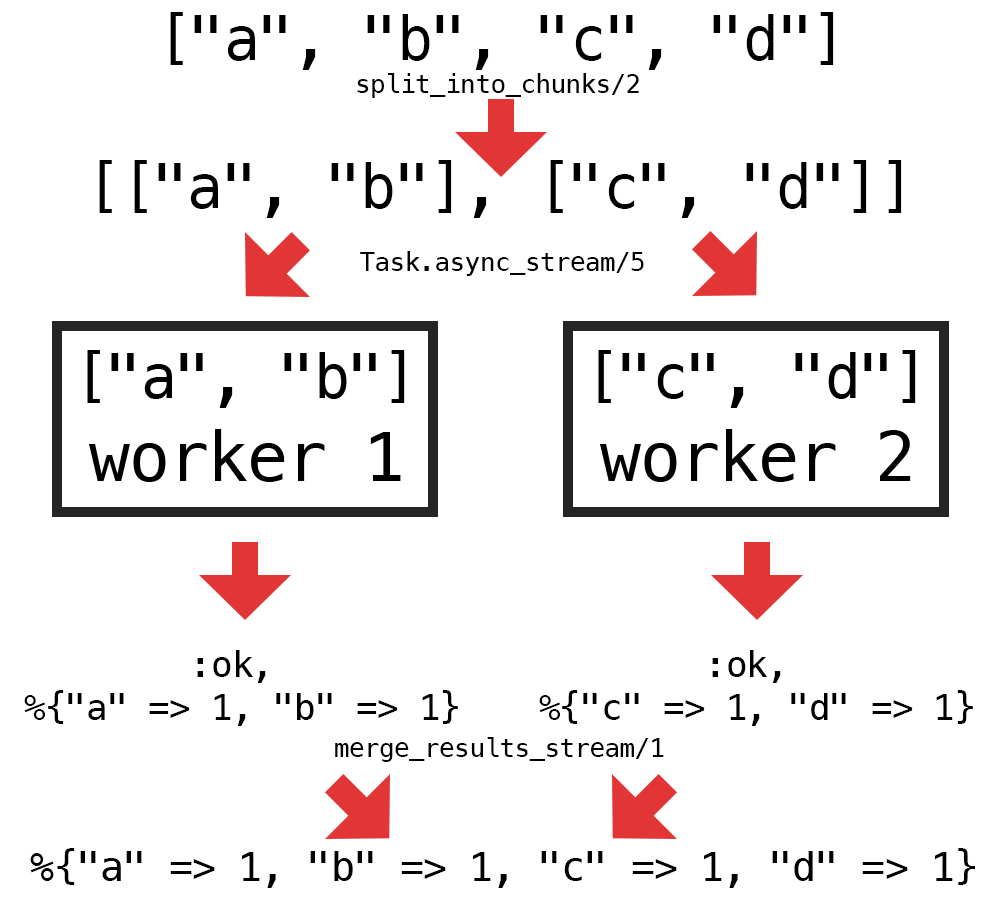
Solo necesitamos implementar 2 funciones auxiliares nuevas para habilitar la lógica concurrente: una para dividir los grafemas en fragmentos (split_into_chunks/2) y otra para combinar el stream de resultados de los workers (merge_results/1). Aquí tienes una forma de implementar esas funciones auxiliares:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
Con esas 2 funciones implementadas, lo único que queda por hacer para que la función frequency/2 se ejecute de forma concurrente es añadir llamadas a las nuevas funciones auxiliares y sustituir la llamada directa a count_letters/1 por Task.async_stream/3:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
La función anterior es una implementación concurrente totalmente funcional y pasa todas las pruebas. A pesar de ser concurrente, el código se lee exactamente igual que el código secuencial normal, lo que demuestra la potencia de las abstracciones que ofrece Task.
¿La versión concurrente es realmente paralela?
Como he mencionado antes en el artículo, en Elixir no hay ninguna distinción entre código concurrente y paralelo. Si establecemos workers en un número mayor que 1 y tenemos más de 1 núcleo de CPU disponible, la VM de la BEAM paraleliza automáticamente la ejecución de los procesos creados.
De forma predeterminada, la BEAM inicia un planificador por cada núcleo de CPU (lógico) disponible. Puedes comprobar el número de planificadores que ha iniciado la BEAM con :erlang.system_info/1:
iex> :erlang.system_info(:schedulers_online)
8
Esto representa el número máximo de procesos de la VM que pueden ejecutarse al mismo tiempo. Establecer workers en un número mayor que el número de planificadores no aumenta el paralelismo y puede perjudicar el rendimiento.
Conclusión
Convertir el código de secuencial a concurrente resulta mucho más fácil de lo esperado con el módulo Task de Elixir. El código concurrente añade algo de complejidad adicional al dividir el array de grafemas y combinar los resultados de los workers, pero el resultado final es sorprendentemente limpio.
Antes de resolver este problema de Exercism había oído hablar de Task, pero nunca lo había usado. Después de aplicarlo en mi solución, ahora lo consideraría una parte indispensable de mi caja de herramientas de Elixir.
Podrías usar esta nueva herramienta de muchas formas para intentar optimizar el rendimiento de tus aplicaciones. La mayoría de las aplicaciones web están limitadas por E/S y, por lo tanto, se beneficiarían de la concurrencia incluso si solo hay un núcleo de CPU disponible. Una forma bastante fiable de acelerar una aplicación web es hacer peticiones HTTP de forma concurrente:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
El código anterior aplica Task.async_stream/3 para llamar a todas las URL del array de forma concurrente, en lugar de esperar a que termine cada petición antes de iniciar la siguiente, lo que debería aportar una mejora de velocidad significativa en función de la duración de cada petición.

