



































이 글이 유용했나요?
주변에 공유해 주세요!
이 글은 Percy Grunwald의 Elixir 시리즈 두 번째 글입니다. Elixir에서의 유니코드 매칭에 관한 첫 번째 글도 놓치지 마세요.
Exercism의 연습 문제는 작고, 인위적이며, 겉보기에는 사소해 보이는 경우가 많아요. 경험 많은 실무자라면 이런 문제에서 배울 게 없다고 생각하기 쉬워요. 하지만 이런 인위적인 문제를 풀다 보면 그동안 살펴보지 못했던 언어의 부분을 배우고 적용하게 될 수 있어요. 이렇게 새로 배운 것은 실제 문제를 더 효율적으로, 혹은 더 표현력 있게 해결하는 데 도움이 될 수 있어요.
병렬 문자 빈도는 Exercism의 Elixir 트랙에 있는 중간 난이도 연습 문제로, 놀랄 만큼 많은 흥미로운 교훈을 담고 있어요. 이 문제를 성공적으로 풀려면 여러 워커 프로세스에서 병렬로 실행되는 풀이여야 해요. Elixir에서 진정한 병렬성을 얻는 것은 다른 언어에 비해 놀랄 만큼 쉬워요. 하지만 Elixir로 동시성 코드를 한 번도 작성해 본 적이 없다면 조금 어렵게 느껴질 수도 있어요. 이 연습 문제를 풀면서 알게 될 것 중 하나는 Elixir가 동시적 또는 병렬로 실행되는 코드를 얼마나 쉽게 작성하게 해 주는가예요. 이런 기술을 코드에 적용하면 애플리케이션 성능에 상당한 영향을 줄 수 있어요.
이 연습 문제에서는 문자열 목록에서 문자 빈도를 계산하는 Frequency.frequency/2 함수를 구현해야 해요. 계산은 workers 인자로 정하는 여러 워커 프로세스에서 수행되어야 해요:
iex> Frequency.frequency(["Freude", "schöner", "Götterfunken"], workers)
%{
  "c" => 1,
  "d" => 1,
  "e" => 5,
  ...
  "ö" => 2
}
이 글에서는 이 연습 문제의 잘 동작하는 순차 풀이를 동시성 코드로 바꾸면서 Elixir의 동시성을 살펴볼 거예요. 그런데 코드로 넘어가기 전에, '동시성'과 '병렬성'이 실제로 무엇을 뜻하는지, 그리고 Elixir와 다른 언어에서 이 둘을 각각 어떻게 얻는지 잠깐 살펴볼까요.
동시성과 병렬성
동시성과 병렬성은 서로 관련된 용어지만 정확히 같은 뜻은 아니에요. 동시적인 프로그램은 여러 작업이 '진행 중'일 수 있지만, 어느 한 시점에 CPU에서 실행되는 작업은 하나뿐인 프로그램이에요. 예를 들어 한 작업을 실행하는 동안 다른 작업은 디스크나 네트워크 읽기/쓰기 같은 IO를 기다리는 경우예요. 반면에 병렬적인 프로그램은 여러 CPU 코어에서 여러 작업을 동시에 실행할 수 있는 프로그램이에요.
동시 실행과 병렬 실행은 모두 속도를 크게 높여줄 수 있지만, 얼마나 빨라질 수 있는지는 (가능하다면 말이에요) 여러 요인에 달려 있어요. 동시성이나 병렬성이 아예 불가능한 경우도 있어요. 풀려는 작업이 동시 실행이나 병렬 실행에 적합하지 않거나, 런타임이 이를 지원하지 않을 수 있어요. 풀려는 문제가 동시 실행이나 병렬 실행을 허용한다면, 얼마나 빨라질 수 있는지는 그 작업이 IO 바운드인지 CPU 바운드인지, 그리고 사용할 수 있는 CPU 코어가 1개보다 많은지에 크게 달려 있어요.
이렇게 요인이 많지만, 동시성이나 병렬성이 가능한지, 그리고 얼마나 빨라질지 판단하는 몇 가지 '경험 법칙'이 있어요. 첫째, 동시 실행은 CPU 코어 하나에서도 가능하지만 병렬 실행은 그렇지 않아요. 둘째, 병렬성과 동시성은 IO 바운드 작업의 속도를 크게 높여 주어야 하고, 그 향상 폭은 둘 다 사실상 같아요. 마지막으로, CPU 바운드 작업은 동시 실행하면 성능이 같거나 오히려 느려지고, 일반적으로 여러 CPU 코어에서 병렬로 실행할 때만 속도가 빨라질 수 있어요.
이 연습 문제의 문자 빈도 계산은 CPU 바운드 작업의 예라서, 위의 경험 법칙에 따르면 여러 CPU 코어에서 병렬로 계산할 때만 속도가 빨라질 수 있어요.
Elixir와 다른 언어의 동시성과 병렬성
널리 쓰이는 많은 언어는 동시성 코드를 작성하는 도구를 제공하지만, 병렬성을 얻는 것은 보통 훨씬 복잡하고 온갖 트레이드오프가 따라요.
예를 들어 Node.js 런타임에서 실행되는 JavaScript에서 동시성은 일급 시민이고, IO 관련 함수의 기본 버전은 거의 항상 '비동기'(즉, 동시적)예요. 예를 들어 fs.ReadFile은 동시성 함수이자 파일 내용을 읽는 표준 방식이에요. 좋은 점이지만 콜백 지옥이나 Promise가 필요하다는 단점도 있어요. 또 Node는 작업 간에 CPU 시간을 공평하게 분배하지 않기 때문에, CPU를 많이 쓰는 작업 하나가 실행을 막아버릴 수도 있어요. Node에서 실행을 병렬화하는 것이 불가능하지는 않지만 결코 쉽지 않아요. Node는 단일 스레드이므로 병렬성을 얻는 유일한 방법은 cluster 모듈로 워커 프로세스를 직접 포크하거나 프로그램 인스턴스를 여러 개 실행해서 그들 사이의 통신을 직접 구현하는 것이에요.
Python은 Node와 달리 기본적으로 동시적이지 않지만, 동시성 및 병렬 코드를 작성하는 여러 도구를 제공해요. 다만 각 방법마다 트레이드오프가 있고 하나를 고르는 것이 꼭 간단하지만은 않아요. threading 모듈을 사용하면 global interpreter lock (GIL)이 한 번에 하나의 스레드만 실행하도록 제한해서 병렬성이 불가능하다는 사실을 감수해야 해요. 다른 방법은 Python의 multiprocessing 모듈인데, 이 모듈은 (스레드가 아니라) OS 프로세스를 만들어 GIL 제약을 우회해요. multiprocessing을 사용하면 병렬성이 가능해지지만, OS 프로세스는 스레드보다 생성이 느리고 메모리도 더 많이 쓴다는 트레이드오프가 있어요.
Elixir는 런타임 수준에서 동시성을 지원하기 때문에 Elixir로 동시성 및 병렬 코드를 작성하는 것은 훨씬 간단해요. Elixir가 대규모 확장성으로 유명한 것은 BEAM 가상 머신 위에서 실행되기 때문인데, BEAM은 모든 코드를 VM 안에서 동시에 실행되는 아주 가벼운 '프로세스' 안에서 실행해요. BEAM 프로세스는 생성 비용이 거의 없고, Python의 동시성 모듈이 만드는 OS 수준 스레드와 프로세스에 비해 아주 적은 메모리만 사용해요. 또한 Node의 이벤트 루프와 달리 BEAM VM에는 사용 가능한 CPU 시간을 모든 프로세스에 할당하는 스케줄러가 있어서, CPU를 많이 쓰는 작업 하나가 다른 프로세스의 실행을 막을 수 없어요.
이런 구조 덕분에 프로세스를 동시에 실행하는 것에서 병렬로 실행하는 것으로 넘어가는 것은 CPU 코어를 더 추가하는 문제일 뿐이에요. 실제로 BEAM은 여러 해째 멀티코어 시스템에서 대칭 다중 처리(SMP) 기능을 자동으로 활성화하는데, 이를 통해 VM의 스케줄러가 모든 코어의 CPU 시간을 실행 중인 프로세스에 할당할 수 있어요. Elixir에서는 동시성이 일급 시민일 뿐만 아니라, 동시성 코드와 병렬 코드 사이에 구분이 없어요. 동시성 코드만 작성하면, 사용 가능한 CPU 코어가 1개보다 많을 때 VM이 자동으로, 기본값으로 그것을 병렬화해 줘요.
Task 모듈로 동시성 Elixir 코드 작성하기
위에서 언급했듯이 Elixir에서는 여러 BEAM 프로세스에 작업을 분산해서 동시성을 얻어요. Kernel.spawn_link/1 같은 함수로 프로세스를 아주 쉽게 만들 수 있지만, Task 모듈이 제공하는 강력한 추상화를 쓰는 편이 훨씬 좋아요:
[Task]의 가장 흔한 사용 사례는 값을 비동기로 계산해서 순차 코드를 동시성 코드로 바꾸는 것이에요.
Task 모듈을 쓰면 Elixir에서 믿을 수 없을 만큼 깔끔한 동시성 코드를 작성할 수 있어요. 콜백 지옥도 없고 Promises도 필요 없어요.
이 연습 문제에는 Task.async_stream/3이 아주 좋은 선택이에요:
async_stream(enumerable, function, options \\ [])
Task.async_stream/3은 enumerable의 각 항목에 대해 주어진 function을 동시에 실행하는 스트림을 반환해요. 기본적으로 생성되는 프로세스(워커)의 수는 enumerable의 항목 수와 같아요. 덕분에 workers 인자로 병렬성 수준을 간단히 조절할 수 있어요 (CPU 코어가 충분하다는 전제하에요). 우리가 할 일은 문자 목록을 알맞은 수의 덩어리로 나누고, Task.async_stream/3으로 각 덩어리를 별도의 워커에서 처리하는 것뿐이에요.
순차 문자 빈도 함수를 동시성으로 만들기
잘 동작하는 순차 구현인 제 풀이부터 시작해 볼까요:
def frequency(texts, _workers) do
  texts
  |> get_all_graphemes()
  |> count_letters()
end

defp get_all_graphemes(texts) do
  texts
  |> Enum.join()
  |> String.graphemes()
end

defp count_letters(graphemes) do
  Enum.reduce(graphemes, %{}, fn grapheme, acc ->
    if String.match?(grapheme, ~r/^\p{L}$/u) do
      downcased_letter = String.downcase(grapheme)
      Map.update(acc, downcased_letter, 1, fn count -> count + 1 end)
    else
      acc
    end
  end)
end
위 구현은 다음과 같이 바꾸면 동시성 코드로 만들 수 있어요:
-
get_all_graphemes/1이 반환한 그래핌 목록을workers수만큼의 덩어리로 나눠요 -
Task.async_stream/3을 사용해서 각 덩어리를 워커에서count_letters/1로 처리해요 - 각 워커의 결과를 하나의 결과로 합쳐요
위 단계를 나타낸 그림이에요:
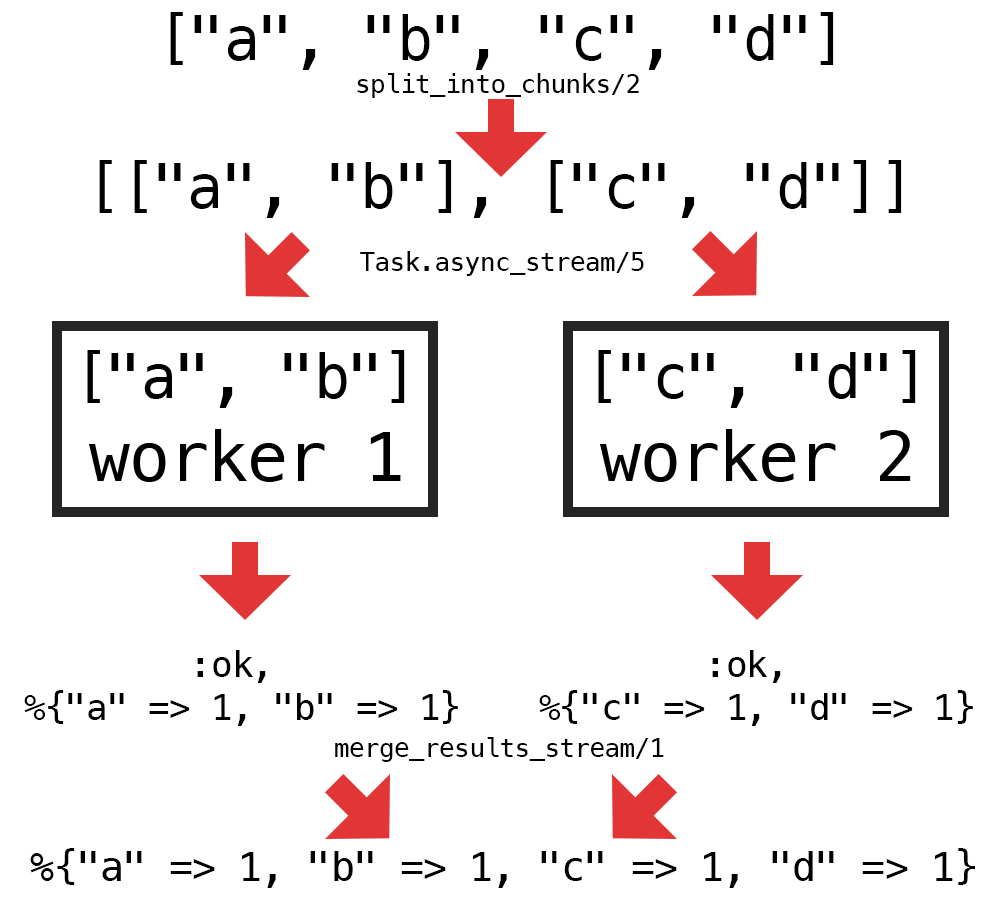
동시성 로직을 적용하려면 새 헬퍼 함수 두 개만 구현하면 돼요. 하나는 그래핌을 덩어리로 나누는 함수(split_into_chunks/2)이고, 다른 하나는 워커의 결과 stream을 합치는 함수(merge_results/1)예요. 이 헬퍼들을 구현하는 한 가지 방법은 다음과 같아요:
defp split_into_chunks(all_graphemes, num_chunks) do
  all_graphemes_count = Enum.count(all_graphemes)
  graphemes_per_chunk = :erlang.ceil(all_graphemes_count / num_chunks)

  Enum.chunk_every(all_graphemes, graphemes_per_chunk)
end

defp merge_results_stream(results_stream) do
  Enum.reduce(results_stream, %{}, fn {:ok, worker_result}, acc ->
    Map.merge(acc, worker_result, fn _key, acc_val, worker_val ->
      acc_val + worker_val
    end)
  end)
end
이 두 함수를 구현하고 나면, frequency/2 함수가 동시적으로 실행되게 하기 위해 남은 일은 새 헬퍼 함수 호출을 추가하고 count_letters/1 직접 호출을 Task.async_stream/3으로 바꾸는 것뿐이에요:
def frequency(texts, workers) do
  texts
  |> get_all_graphemes()
  |> split_into_chunks(workers)
  |> Task.async_stream(&count_letters/1)
  |> merge_results_stream()
end
위 함수는 완벽하게 동작하는 동시성 구현이고 모든 테스트를 통과해요. 동시성이지만 코드는 일반적인 순차 코드와 똑같이 읽혀요. 이는 Task가 제공하는 추상화의 힘을 보여줘요.
동시성 버전은 정말로 병렬일까요?
앞서 글에서 언급했듯이 Elixir에서는 동시성 코드와 병렬 코드 사이에 구분이 없어요. workers를 1보다 큰 수로 설정하고 사용 가능한 CPU 코어가 1개보다 많으면, BEAM VM이 생성된 프로세스의 실행을 자동으로 병렬화해요.
기본적으로 BEAM은 사용 가능한 (논리) CPU 코어마다 스케줄러를 하나씩 시작해요. BEAM이 시작한 스케줄러 수는 :erlang.system_info/1로 확인할 수 있어요:
iex> :erlang.system_info(:schedulers_online)
8
이 숫자는 동시에 실행될 수 있는 VM 프로세스의 최대 개수예요. workers를 스케줄러 수보다 더 큰 수로 설정해도 병렬성은 늘지 않고 오히려 성능이 나빠질 수 있어요.
마무리
Elixir의 Task 모듈을 쓰면 코드를 순차에서 동시성으로 바꾸는 일이 생각보다 훨씬 쉬워요. 동시성 코드는 그래핌 목록을 나누고 워커 결과를 합치는 부분에서 약간의 복잡함이 더해지지만, 최종 결과는 놀랄 만큼 깔끔해요.
이 Exercism 문제를 풀기 전에는 Task에 대해 들어본 적은 있어도 써 본 적은 없었어요. 제 풀이에 적용해 본 뒤로는 Elixir 도구 상자에서 없어서는 안 될 부분이라고 생각해요.
이 새로운 도구를 여러 방식으로 활용해서 애플리케이션 성능을 최적화해 볼 수 있어요. 대부분의 웹 애플리케이션은 IO 바운드라서, CPU 코어가 하나뿐이더라도 동시성의 이점을 볼 수 있어요. 웹 애플리케이션 속도를 높이는 꽤 믿을 만한 방법 하나는 HTTP 요청을 동시에 보내는 것이에요:
def call_apis_async() do
  ["https://api.example.com/users/123", ...]
  |> Task.async_stream(&HTTPoison.get/1)
  |> Enum.into([], fn {:ok, res} -> res end)
end
위 코드는 Task.async_stream/3을 적용해서 목록의 모든 URL을 동시에 호출해요. 각 요청이 끝나기를 기다렸다가 다음 요청을 시작하는 방식과 달리, 각 요청의 지속 시간에 따라 속도가 크게 향상될 수 있어요.

